Traduit de l'anglais.
Quand vous demandez à PitStopper d'afficher les cafés, robinets d'eau, commerces ou abris le long d'un parcours, il doit répondre à une question qui a l'air simple et ne l'est pas :
Quels lieux se trouvent à moins de 500 mètres de cette ligne de 200 km ?
Pas près d'un point. Pas dans un rectangle. Le long d'une ligne sinueuse, sur 200 km, avec une réponse qui arrive avant que le cycliste ne s'ennuie.
Cette question a une bonne réponse et plusieurs mauvaises réponses plausibles. Nous avons fait tourner l'une des mauvaises pendant huit mois, et la façon évidente de la corriger s'avère en être une autre. Cet article explique comment fonctionne la bonne : ce qu'est PostGIS, pourquoi la requête évidente se révèle lente, et la petite astuce qui rend la version finale rapide.
D'abord, ce qu'est PostGIS
Trois couches, et seule celle du milieu est peu connue.
PostgreSQL est une base de données ordinaire, du genre de celles qui tournent derrière la plupart des sites web. Elle stocke des lignes de données et permet de les chercher et de les filtrer.
PostGIS est une extension de PostgreSQL qui lui apprend les formes. Une colonne peut contenir un point, une ligne ou une surface, comme une autre colonne contient un nom ou un prix, et quelques centaines de nouvelles fonctions permettent de poser des questions à leur sujet : qu'est-ce qui est près de quoi, qu'est-ce qui croise quoi, quelle distance sépare deux choses.
PitStopper utilise les deux ensemble pour garder une copie interrogeable d'OpenStreetMap, et lui demande où se trouvent les choses par rapport à votre parcours.
Concrètement, un café dans notre base est une ligne qui ressemble à peu près à ceci :
name      The Coffee House
location  POINT(-0.9016 51.5372)
tags      amenity=cafe
Et un parcours que vous avez chargé est lui aussi une forme :
geometry LINESTRING(-0.89 51.53, -0.91 51.54, ...)
Votre parcours n'est pas stocké avec les cafés : il arrive avec la question et repart ensuite. Mais une fois les deux exprimés dans le même langage, une question devient possible : lesquels de ces points sont à moins de 500 mètres de cette ligne ? C'est toute l'idée, et tout ce qui suit sert à la rendre rapide.
D'où viennent les données
OpenStreetMap est une carte libre du monde que tout le monde peut modifier, le Wikipédia des cartes. Plus de deux millions de personnes y ont ajouté les routes, chemins, cafés, bancs et robinets d'eau autour de chez elles. Tout y est décrit par de simples étiquettes clé-valeur appelées tags : un café est amenity=cafe et une fontaine d'eau potable amenity=drinking_water, et c'est sur eux que portent nos recherches.
Ce qui compte ici, c'est que toute la base peut être téléchargée. Nous ne demandons pas poliment au service cartographique de quelqu'un d'autre : nous avons notre propre copie et nous lui demandons ce que nous voulons.
Le hic, c'est qu'une copie vieillit, et OSM ne s'arrête jamais : des millions de modifications par jour, tous les jours. C'est pour cela que nos mises à jour tournent toutes les heures, et pas quand on y pense.
Pourquoi ne pas simplement interroger OpenStreetMap ?
Bonne question, et pendant longtemps, c'est exactement ce que nous faisions.
OpenStreetMap, ce sont les données. Les interroger est un autre problème, et Overpass en est la réponse habituelle. C'est par là que PitStopper a commencé, et la plupart du temps sur notre propre matériel : nous avons fait tourner notre propre instance Overpass, tenue à jour, pendant huit mois.
Ça marchait. C'était juste lent, et de plus en plus lent à mesure que le parcours s'allongeait, à cause de la forme de la question et non de celle du matériel. Overpass répond bien à « qu'y a-t-il dans ce rectangle ». On peut l'interroger sur une ligne (around: accepte une polyligne entière, pas seulement un point), mais sur un parcours de milliers de points, cette requête est assez coûteuse pour être impraticable, et il nous revenait moins cher d'envoyer beaucoup de rectangles à la place. C'est ce que nous avons fait : une requête par rectangle, puis à nouveau pour chaque catégorie.
Détenir les données nous-mêmes n'a jamais été le problème. Ce qui a changé, c'est ce que nous pouvions leur demander. Mettez les mêmes données OpenStreetMap dans PostGIS et la requête peut être taillée pour ce dont PitStopper a vraiment besoin, au lieu d'être assemblée à partir de la seule question que l'API sait traiter.
Postpass est l'étape intermédiaire qui nous a montré que ça valait la peine. Il met OpenStreetMap dans PostGIS et expose du SQL par HTTP : vous lui envoyez une requête plutôt que des paramètres, et il vous renvoie du GeoJSON, un format texte simple pour décrire des formes. Pas de radius=, pas d'ensemble figé de points d'accès, juste du SQL sur un miroir de la planète entière. Cette ouverture rend tout à fait ordinaire toute une catégorie de questions qui posent problème à Overpass.
Trois noms reviennent à partir d'ici, et ils ne diffèrent que d'une lettre et d'une idée :
- Overpass : la façon historique d'interroger OpenStreetMap. Bon pour « qu'y a-t-il dans ce rectangle ». Ce que nous avons utilisé pendant nos huit premiers mois.
- Postpass : les mêmes données dans PostGIS, qui répondent à du SQL envoyé par HTTP. L'origine de la requête en corridor, et toujours le dernier recours si nos deux machines sont en panne.
- Notre propre serveur : la même recette, avec le SQL déplacé dans la base de données pour que le navigateur n'envoie plus que des nombres. C'est lui qui répond aujourd'hui.
Tout commence par un rectangle
Une base de données spatiale est rapide pour une seule raison. Elle ne compare pas votre requête à chaque ligne. Elle garde un rectangle englobant pour chaque objet, un simple rectangle autour de lui, et l'index spatial lui permet d'écarter en une seule étape tout ce dont le rectangle ne touche pas le vôtre. Seuls les survivants passent le test géométrique exact, qui est coûteux.
Cet index porte un nom que vous croiserez dans toute discussion sur PostGIS : GiST. C'est celui que PostGIS construit sur une colonne de géométrie, et c'est lui qui fait de « quels rectangles chevauchent ce rectangle » une seule consultation au lieu de 75 millions de comparaisons. Quand cet article dit « l'index », c'est de lui qu'il s'agit.
En gros, l'index peut dire : ce café n'est manifestement pas du tout dans la zone qui nous intéresse, ignorons-le.
La taille de votre rectangle décide donc de tout.
Demandez « qu'y a-t-il à moins de 500 m de ce café » et votre rectangle est un carré d'un kilomètre de côté. L'index jette la planète et rend une quarantaine de candidats. Demandez « qu'y a-t-il à moins de 500 m de ce parcours de 200 km » et votre rectangle est le plus petit rectangle qui contient tout le parcours, soit un département ou deux. L'index écarte encore, mais un rectangle de cette taille garde environ un million de candidats, et chacun d'eux passe le test exact, un par un.
Ce seul fait explique à la fois l'approche que nous avons mise en service et la requête qu'on écrirait naturellement pour la remplacer.
Notre première version : des rectangles à perte de vue
Couvrir le parcours d'une chaîne de rectangles englobants et interroger chacun d'eux. C'est ce qu'ont été ces huit mois. Ça marche, et ça gaspille énormément, parce qu'un rectangle autour d'un tronçon de route en diagonale contient surtout des champs, et qu'un parcours qui tourne demande beaucoup de rectangles. Overpass réagit aussi mal à une requête unique qui porte plus d'une poignée de filtres de tags sans rapport entre eux, donc nous n'envoyions jamais plus de six catégories à la fois : c'était rectangles multipliés par catégories, et une longue sortie devenait des dizaines de requêtes, dont plusieurs expiraient.
Il faut être clair sur l'endroit où le temps passait, parce que ce n'était pas le serveur. Notre instance était à nous, elle était à jour, et elle ne partageait sa capacité avec personne. Le coût venait de la forme de la question : des dizaines d'allers-retours par recherche, chacun rapportant des choses devant lesquelles le cycliste ne passerait jamais.
Le corridor est la forme que vous voulez vraiment
Nous ne voulons pas vraiment chercher dans un rectangle. Ni dans cent petits rectangles.
Ce que nous voulons vraiment dire, c'est : donne-moi tout ce qui se trouve dans cette bande qui suit le parcours.
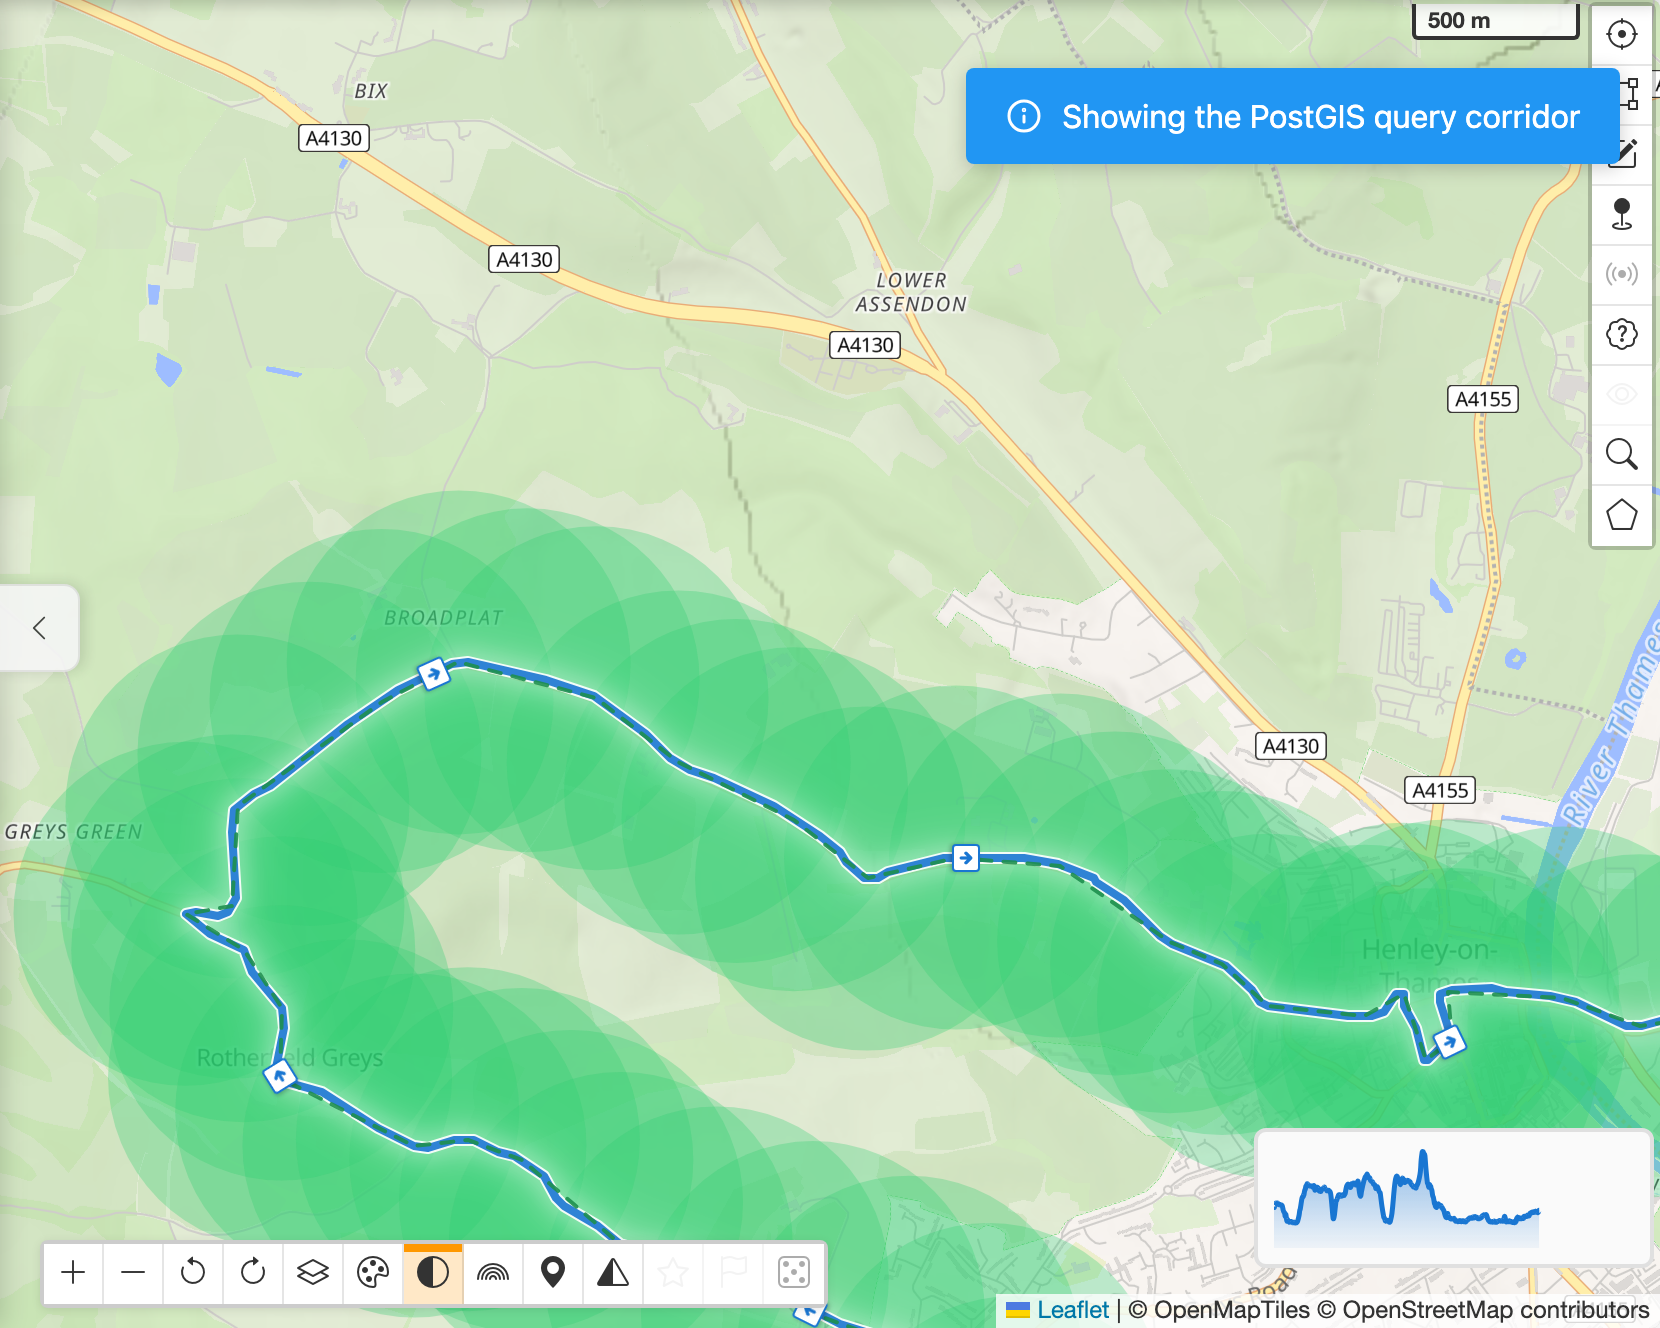
C'est un corridor. Si le parcours fait 200 km et que le rayon de recherche est de 500 mètres, le corridor est simplement le parcours élargi de 500 mètres de chaque côté. PostGIS dessine cette forme pour nous, avec une fonction appelée ST_Buffer.
L'important, c'est que ce n'est pas une approximation du parcours. C'est la zone de recherche que nous voulons vraiment. En voici une, dessinée par l'application avec le rayon qu'utilise réellement la requête :
Et la même vue après la recherche, avec les points renvoyés par ce corridor :
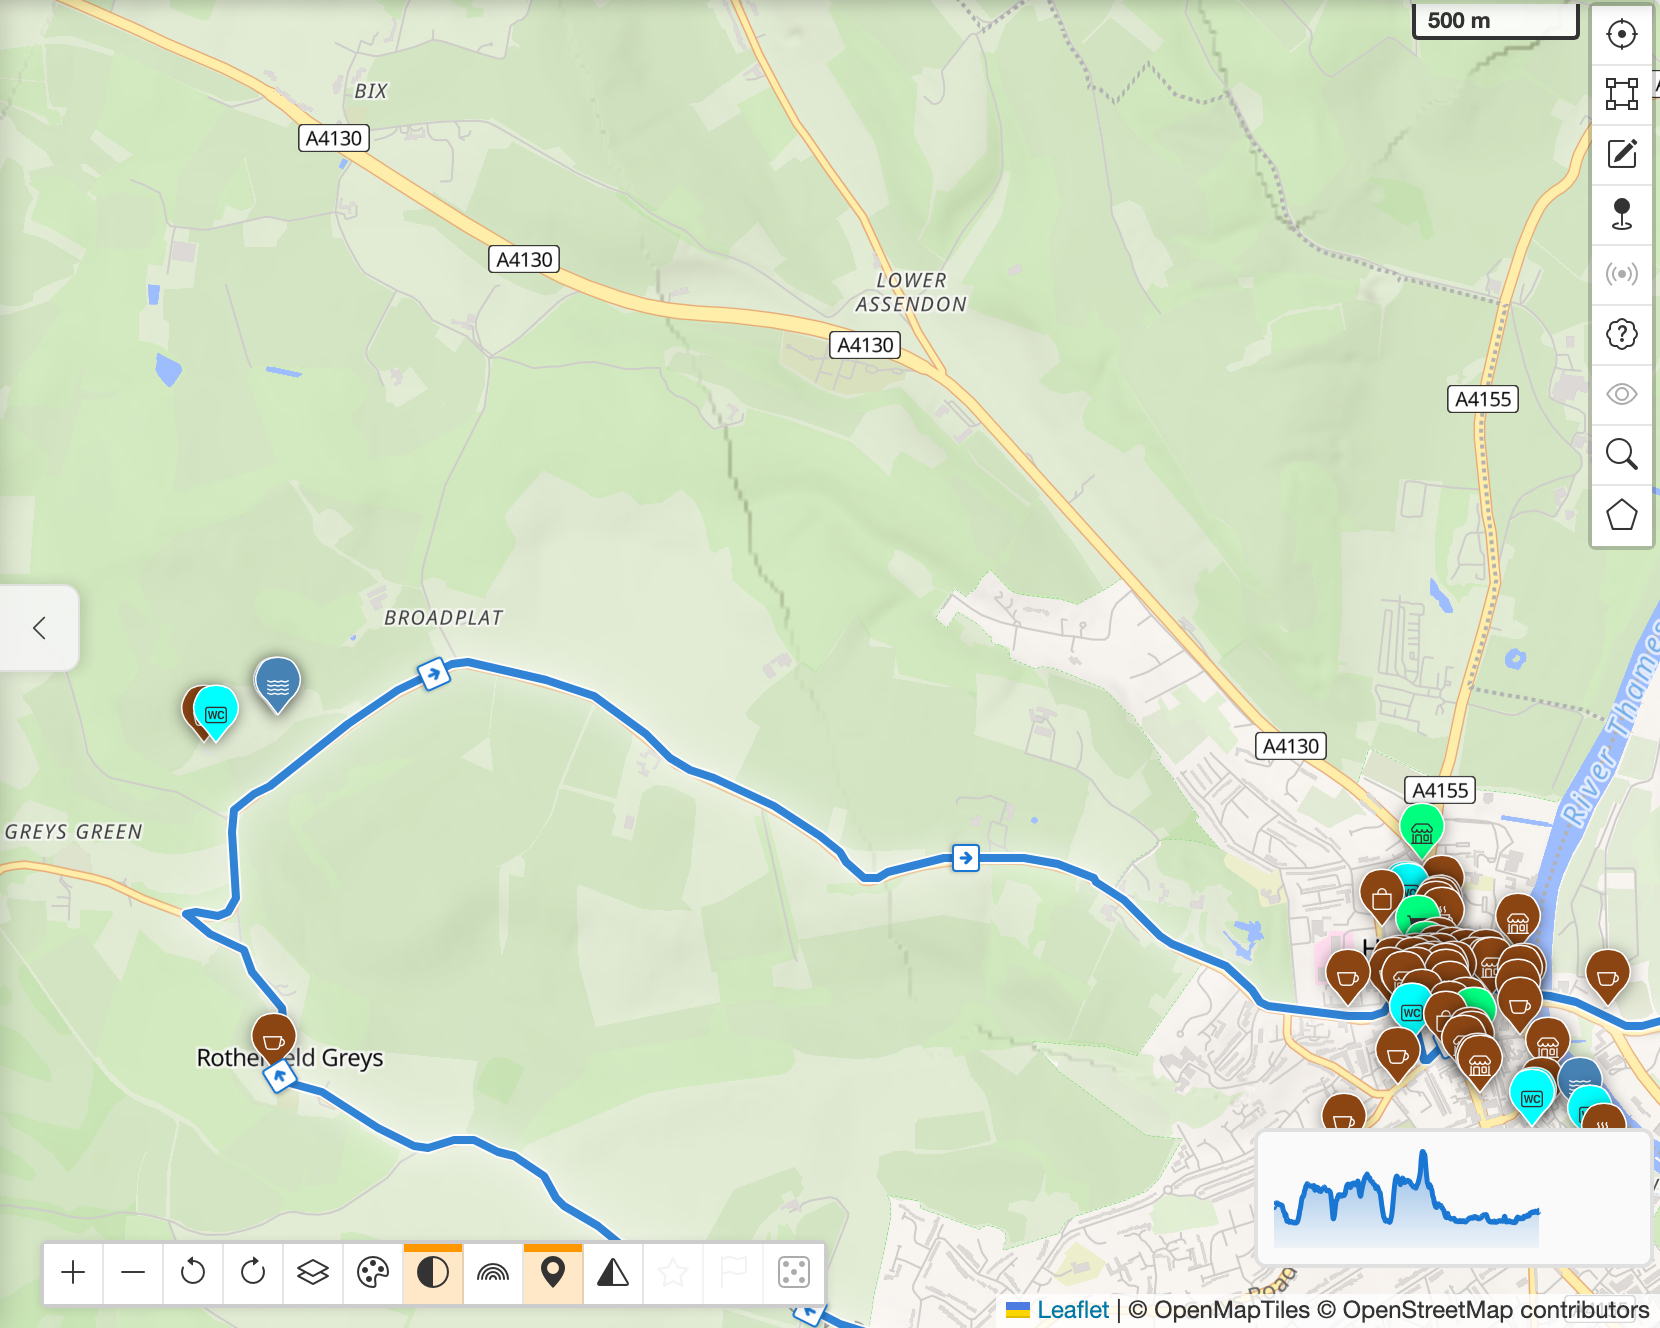
Le groupe à Henley, on s'y attendait. La paire à Broadplat est la plus intéressante : à plusieurs centaines de mètres de la route, rien autour, exactement ce qu'un test « proche du parcours » bâclé laisse tomber. C'est aussi le seul point d'eau sur huit kilomètres.
La requête qu'on écrit en premier
Passez à PostGIS et le corridor n'est plus une forme qu'il faut approcher avec des rectangles. Vous pouvez simplement la demander :
SELECT * FROM pois
WHERE ST_DWithin(geom::geography, route::geography, 500);
En clair : donne-moi chaque lieu qui se trouve à moins de 500 mètres de ce parcours.
Si le SQL n'est pas votre langue, voici les morceaux :
poisest notre table de lieux, une ligne par café, robinet, banc ou abri. 75 millions en tout.geomest l'emplacement d'un lieu, etrouteest la ligne que vous avez chargée.ST_DWithinest la question : ces deux formes sont-elles à moins de 500 l'une de l'autre ? Presque toutes les fonctions PostGIS s'appellentST_quelque chose, pour « spatial type ».::geographyest ce qui fait que500veut dire 500 mètres et non 500 degrés. C'est plus important qu'il n'y paraît, et une section à la fin raconte cette histoire à qui veut la connaître.
Correcte, lisible, et un parcours complet de la table déguisé en index spatial. « Chaque lieu que nous avons », ce sont 75 millions de calculs de distance par rapport à une ligne de 200 km.
Elle a deux défauts, et le second est le sujet de cet article. Le problème immédiat, c'est ce ::geography : convertir une colonne au passage empêche complètement d'interroger l'index construit sur cette colonne, si bien que la requête n'atteint jamais l'étape du rectangle. Corrigez cela, et vous tombez sur le rectangle : celui qui entoure une ligne de 200 km livre toujours l'essentiel de la base au test exact, qui doit tout moudre. La conversion est une erreur qu'on corrige en une minute ; le rectangle, c'est la forme même du problème. La section sur le planificateur plus bas apporte les preuves pour les deux.
La solution : découper la bande en tuiles
Un corridor de 200 km est lui-même une forme énorme, et le rectangle qui l'entoure couvre le même département ou deux qu'avant. Nous le découpons donc en courts tronçons, avec ST_Subdivide.
Imaginez que vous donnez à la base de données une carte faite de petites tuiles au lieu d'une seule immense feuille. Chaque tuile est petite, donc le rectangle qui l'entoure est petit, donc l'index redevient utile : pour chaque tuile, il peut jeter presque toute la base en une étape. Même réponse, trouvée pour une fraction du travail.
La distinction à retenir, c'est que nous découpons le corridor pour le bien de la base de données, pas parce que nous faisons une approximation du parcours. La bande reste la bande.
On ne faisait pas déjà ça avec des rectangles ?
Dites vite, les deux approches ressemblent à la même idée deux fois : découper le parcours, interroger chaque morceau. La différence, c'est la nature des morceaux, et qui les voit.
| Rectangles, via Overpass | Cellules de corridor, dans PostGIS |
|---|---|
| Les rectangles sont jetés sur le parcours | Le corridor suit déjà le parcours |
| Le rectangle est la question | La cellule est la façon de poser la question à l'index |
| Envoyés sur le réseau, une requête chacun | Ne quittent jamais la base de données |
| Tout ce qui est dans le rectangle revient | Les candidats sont d'abord testés contre la vraie bande |
| Un café à trois champs de là est un résultat | Un café à trois champs de là est écarté avant l'envoi de la réponse |
| Des dizaines de requêtes, dont certaines expirent | Une requête, toutes les catégories à la fois |
Les rectangles Overpass étaient la question : un rectangle partait sur le réseau et tout ce qu'il contenait revenait, y compris le café à trois kilomètres de la route. Les cellules du corridor sont de la tuyauterie que personne ne voit : chacune fait remonter une poignée de candidats, et chaque candidat est ensuite testé contre la bande elle-même avant que la réponse ne quitte la base. Le découpage est resté ; ce qui est découpé, et ce qui revient, ont changé tous les deux.
Ce qui se passe vraiment quand vous cherchez
your route
    |  thinned to a few hundred points
    v
sent as a list of points
    |  turned into GeoJSON on the server
    v
a line the database understands
    |  ST_Buffer, 500 m
    v
a corridor
    |  ST_Subdivide
    v
short sections
    |  spatial index, one step per section
    v
candidate places
    |  tested against the real corridor, then the tag filters
    v
results
La plupart des recherches ne dépassent jamais la première ligne de ce schéma, parce que la réponse est déjà dans le navigateur. « Le cache qui cache tout ça », plus bas, explique pourquoi.
Ce que ça change pour un cycliste
Revenez à ces deux robinets de Broadplat : à quelques centaines de mètres de la route, le seul point d'eau sur huit kilomètres, et exactement ce qu'un rectangle dessiné près du parcours attrape ou rate selon l'endroit où il s'arrête. Poser la vraie question (tout ce qui se trouve dans une bande de 500 mètres de chaque côté de la ligne que je suis) est le moyen de les récupérer. C'est à ça que sert tout ceci. Le reste, c'est ce que ça rend possible :
- Les longs parcours ne veulent plus dire des dizaines de recherches séparées.
- Toutes les catégories sont cherchées ensemble, au lieu d'une requête chacune.
- La zone de recherche suit le parcours, au lieu d'être une collection de grands rectangles à proximité.
- Le filtrage se fait dans la base de données, donc ce qui passe sur le réseau est la réponse et non la matière première.
- La même approche fonctionne pour une boucle de 20 km en soirée et pour un voyage de 700 km.
Demandez tout ce qui se trouve à moins de 500 mètres d'un parcours de 700 km, et c'est une seule question, posée une seule fois.
Les chiffres. Deux séries de mesures le même jour, le 11 juillet 2026, avec le banc de test du dépôt (tests/e2e/poi-backend-compare.diag.spec.js), sur le site de préproduction. Il importe de savoir laquelle est laquelle.
La première est celle qui a justifié le changement. Elle opposait l'ancien chemin Overpass à une requête en corridor PostGIS, à froid des deux côtés :
| la recherche | Overpass | corridor PostGIS |
|---|---|---|
| 6 km, 8 catégories | 4,3 s | 0,19 s |
| 180 km, 8 catégories | 9,7 s | 0,66 s |
| 180 km, 20 catégories à 1 km | 20,1 s | 0,85 s |
| 700 km, 8 catégories | jamais terminée, délai de 120 s dépassé | 2,8 s |
| 700 km, 20 catégories à 1 km | jamais terminée, délai de 120 s dépassé | 4,1 s |
De quinze à vingt-quatre fois plus rapide sur les recherches qui ont abouti, et deux qui ont cessé d'être des échecs. La colonne PostGIS correspond ici au Postpass public de Geofabrik, parce qu'à ce moment-là nous n'avions encore rien construit nous-mêmes. (Le tableau complet dans le dépôt a onze lignes et un écart plus large, de 3x sur une recherche dense autour d'un point de 5 km à 34x sur un court parcours avec vingt catégories.)
Plus tard le même soir, une fois notre propre serveur en place, une seconde série a mis les trois côte à côte. Notre nœud a battu l'instance publique sur chaque ligne, ce qui est l'argument pour héberger le sien : même idée, mais les questions sont fixées à l'avance et les données filtrées sur ce que nous demandons réellement.
| la recherche | Postpass public | notre propre serveur |
|---|---|---|
| 6 km, 1 catégorie | 157 ms | 79 ms |
| 180 km, 1 catégorie | 909 ms | 182 ms |
| 180 km, 8 catégories | 685 ms | 241 ms |
| 180 km, 20 catégories à 1 km | 933 ms | 312 ms |
| parkings à 170 m, Reading | délai de 8 s dépassé | 206 ms |
Deux de ces lignes méritent une réserve plutôt qu'un cocorico.
Une catégorie sur le parcours de 180 km est revenue plus lentement que huit sur le même parcours, ce qui ne peut pas refléter le travail effectué. L'instance publique est un service gratuit et partagé, sans cache de réponses, donc ses chiffres varient avec tout ce que les autres lui demandent au même moment. Lisez cette colonne comme un ordre de grandeur, rien de plus fin. Ce bruit fait partie de l'argument pour héberger le sien ; ce n'est pas la preuve que nous sommes quatre fois meilleurs à ce jeu-là.
La ligne des parkings n'est pas non plus un bogue de Postpass, et c'est la ligne la plus utile du tableau. amenity=parking est l'un des plus grands ensembles de tags d'OpenStreetMap : nous en avons 6 779 228, et les compter simplement, sans aucune géographie, prend environ trois secondes à notre propre nœud. La réponse à « les parkings à moins de 170 mètres de ce point à Reading » est deux, en 206 ms. Tout repose sur le fait d'écarter les 6 779 226 autres par rectangle avant de regarder le moindre tag, ce qui est le sujet de tout cet article, et exactement ce que la conversion ::geography empêche en silence.
Deux séries sur une journée : lisez donc tout cela comme des ordres de grandeur plutôt que comme des benchmarks. C'est l'allure qui compte : la recherche a cessé d'exploser avec la longueur du parcours.
La bande fait vraiment des mètres de large
Comme la bande est dessinée en mètres et non en degrés, sa largeur est juste à n'importe quelle latitude, et la surcouche de débogage la dessine de la même façon. Ce que vous voyez sur la carte, c'est la requête.
geography est ce qui fait que 500 veut dire 500 mètres partout.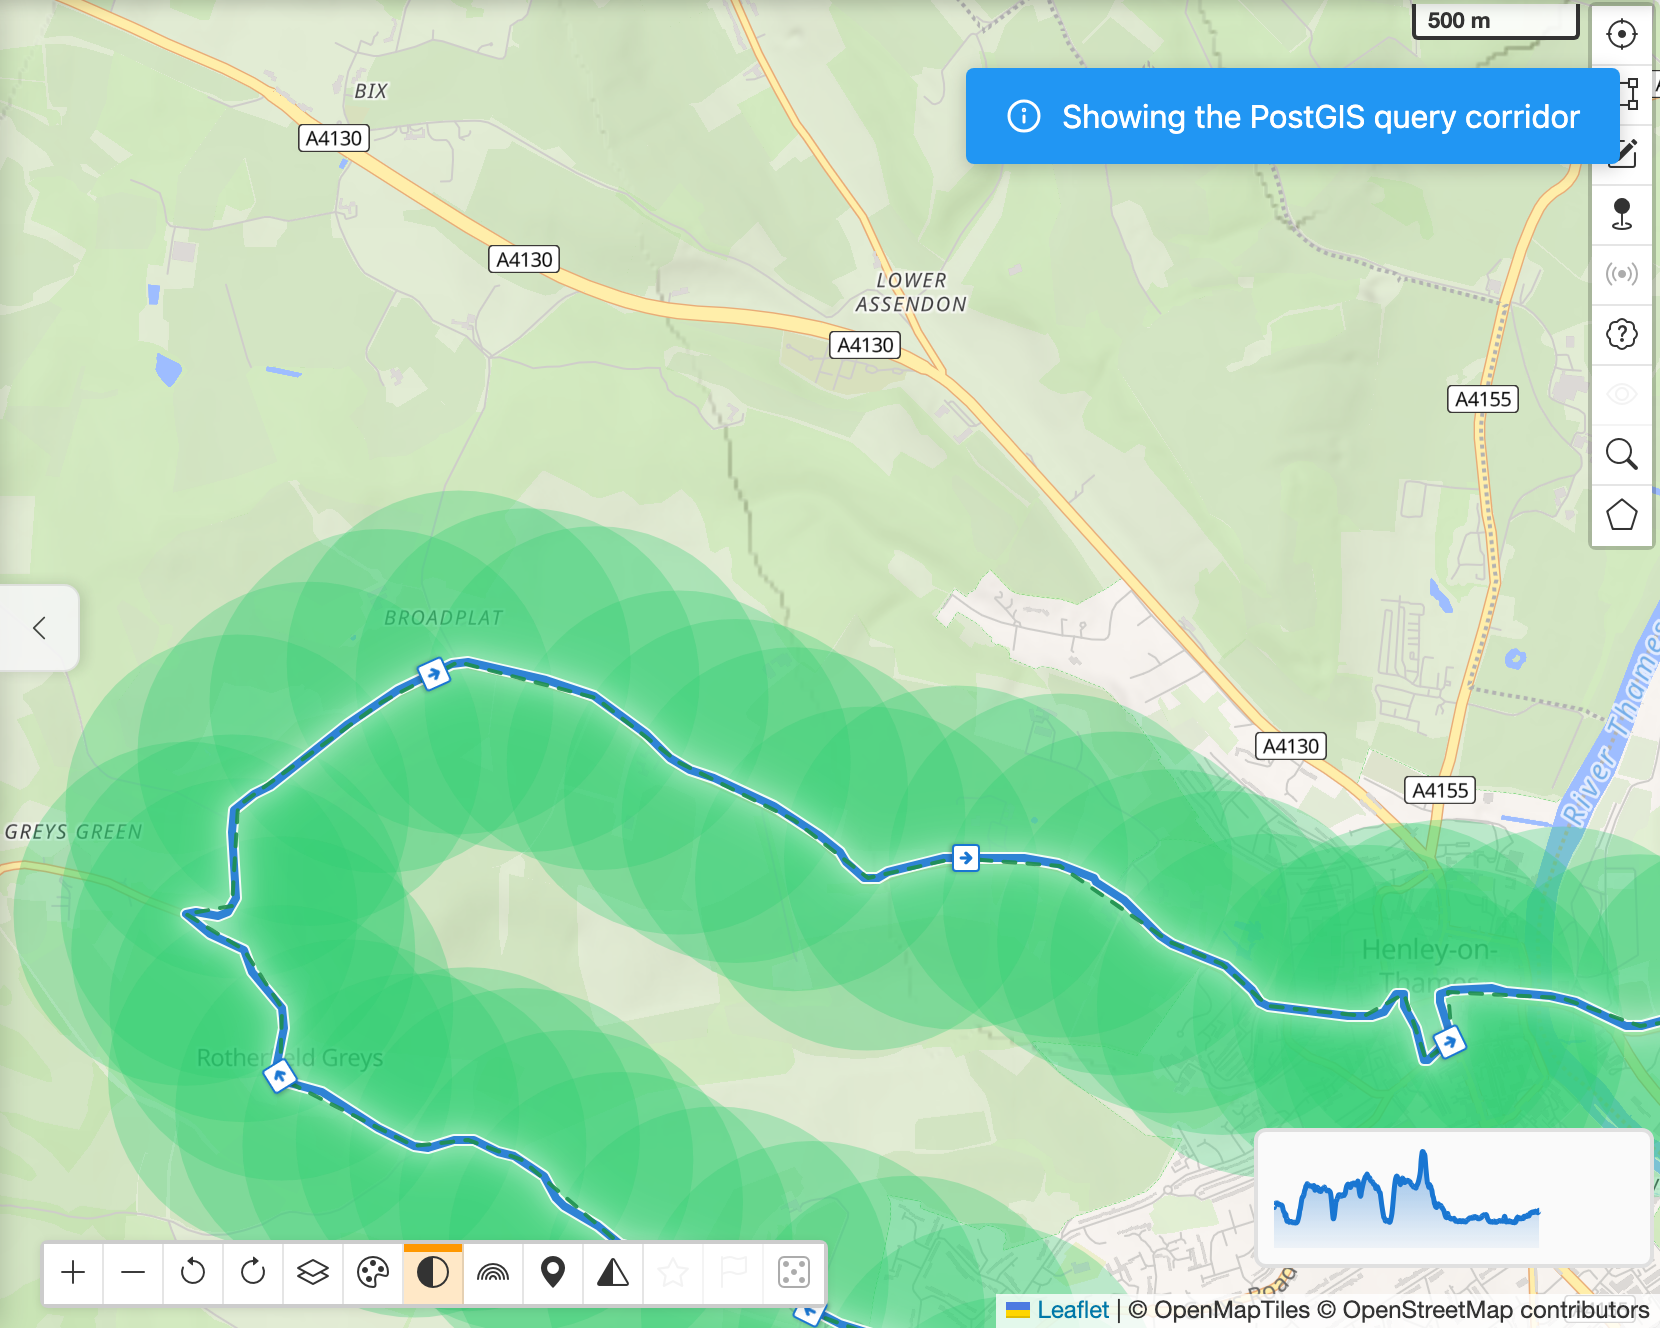
C'est la même vue à 100 m au lieu de 500 m. Rien ne change dans la requête, à part le nombre.
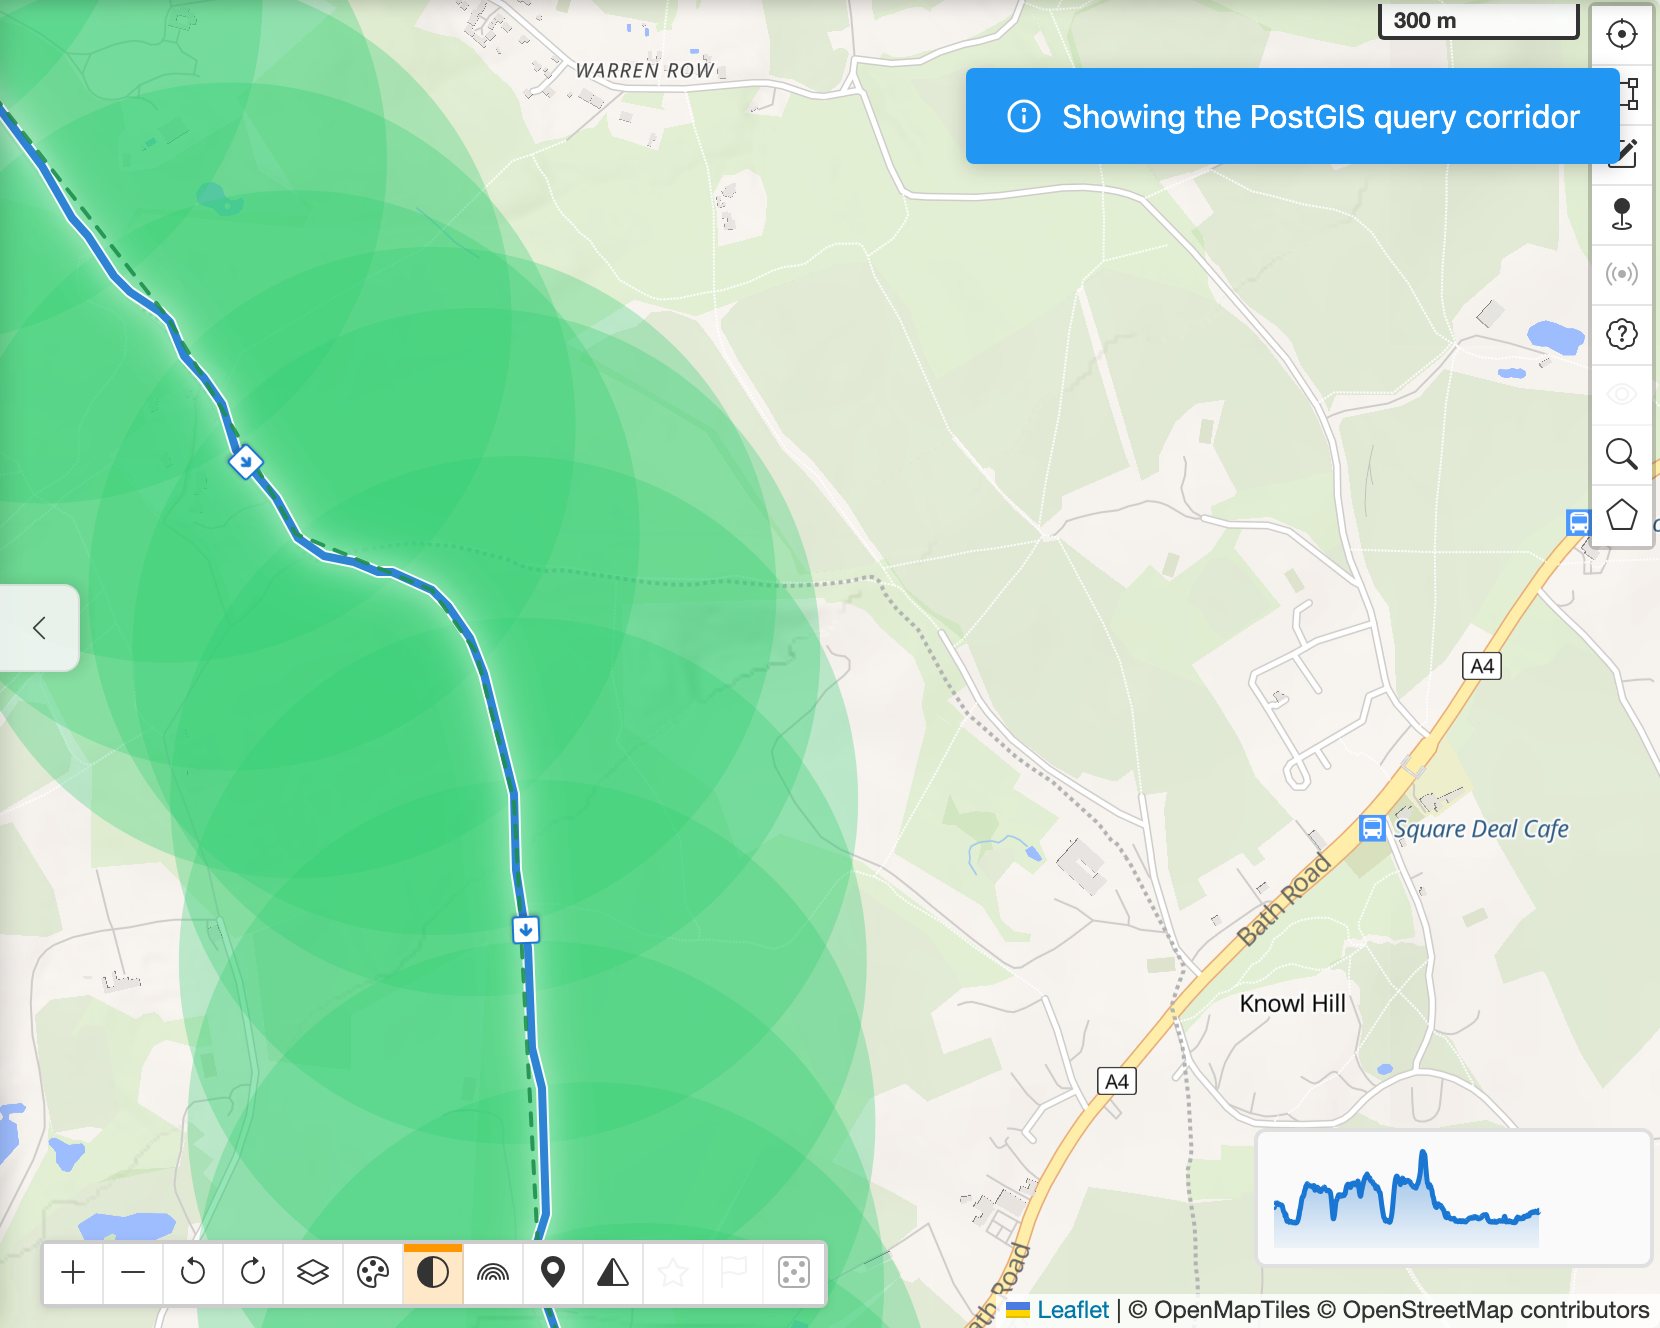
La même surcouche dans un virage. Le bord de la bande reste à la même distance de la route tout au long de la courbe, ce qui est exactement le sens de « à moins de 500 mètres du parcours ». Tout ce qui est à l'est ne fait tout simplement pas partie de la question : les champs, Knowl Hill, l'A4 qui le traverse.
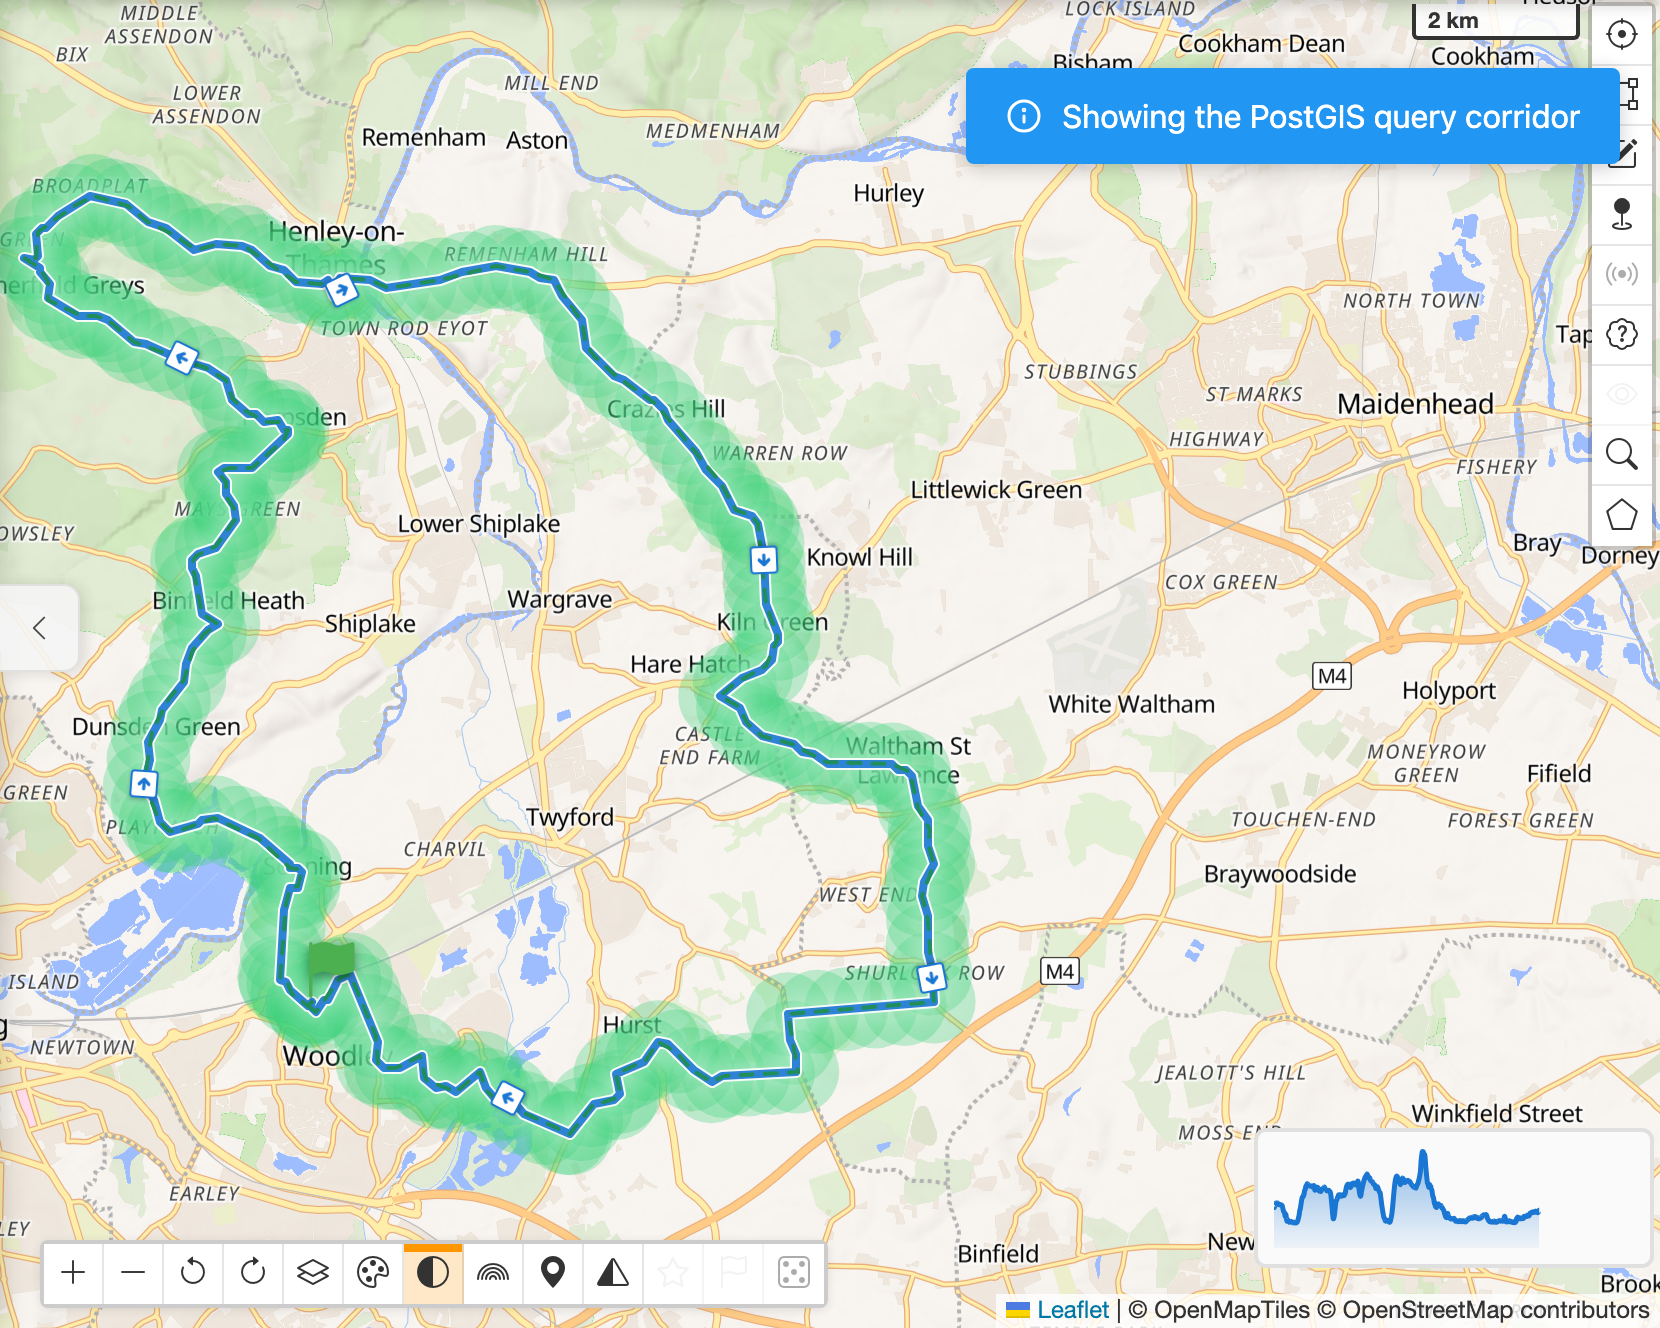
Toute la sortie de 44 km. Une seule requête.
Avant que la requête ne quitte le navigateur
La plupart des points du parcours sont d'abord jetés. Un GPX enregistré en contient dix mille ; le corridor en a besoin de quelques centaines. Douglas-Peucker avec une tolérance de 25 m se charge de l'allègement, et il divise la taille de la requête par dix. Le compromis est précis et mérite d'être dit : la ligne allégée reste à moins de 25 m de la ligne enregistrée, donc le bord du corridor peut bouger de 25 m au plus. Un robinet à 490 m de la trace que vous avez suivie peut se retrouver à 515 m de la ligne que nous envoyons. Avec un rayon de 500 m, personne ne le remarque ; à 100 m, c'est un quart de la largeur, et c'est le rayon où il faut y penser. La surcouche dessine la ligne allégée, pour que l'image reste honnête sur ce qui a vraiment été envoyé.
Un plafond de 10 000 points et un rayon de 35 km, imposés par le serveur. Personne ne demande plus. Nous préférons simplement trouver la limite nous-mêmes plutôt qu'un cycliste ne la découvre un dimanche matin.
Le cache qui cache tout ça
La requête la plus rapide est celle que personne n'exécute. Alors, quelques secondes après la fin du chargement d'un parcours, pendant que vous regardez encore la carte, PitStopper demande discrètement tout : les 89 catégories intégrées, le long de chaque parcours chargé, à un kilomètre de chaque côté. Les longs parcours partent en tronçons de 250 km, deux à la fois, et le tout est abandonné dès que vous lancez vous-même une recherche, pour que ce travail spéculatif ne passe jamais devant une vraie question. Il ne s'adresse qu'à notre propre serveur, jamais à l'instance publique qui nous sert de secours.
Ce qui revient est stocké par catégorie dans le navigateur, dans IndexedDB, avec deux informations de suivi qui comptent plus que les lieux eux-mêmes : le rayon utilisé pour la récupération, et si la récupération s'est réellement terminée.
Ces deux champs suffisent à décider de leur réutilisation. Une entrée répond à votre recherche si elle est complète et si son rayon de récupération est au moins égal au rayon que vous demandez. Cocher Cafés avec les 500 m par défaut n'est donc pas une recherche du tout : c'est une consultation, et l'application mesure elle-même les distances le long de votre parcours. Faites glisser le curseur de rayon au-delà d'un kilomètre et l'entrée en cache ne couvre plus la question, donc la requête en corridor repart pour de vrai. Une récupération qui a échoué est enregistrée comme incomplète et jamais réutilisée, parce que « rien ici » et « nous ne l'avons jamais su » sont deux réponses différentes.
Indexer ce cache par parcours s'est révélé une mauvaise intuition : un café ne bouge pas quand vous déplacez un waypoint, mais une clé liée à la forme du parcours, si, ce qui laisse orphelins les lieux de tout un corridor. Les entrées passent donc à une grille fixe de cellules géographiques. Une cellule appartient au monde et non à votre parcours, donc la même cellule répond pour le parcours que vous avez modifié, celui que vous avez chargé deux fois, et celui de quelqu'un d'autre sur la même route.
Ce qui relativise un peu ce qui précède. La plupart du temps, la base de données n'intervient pas : vous cochez des catégories, vous réglez le rayon sous un kilomètre, et rien ne quitte le navigateur. La vitesse de la requête en corridor est cachée derrière un cache, ce qui est exactement sa place, et cela veut dire que les chiffres de cet article ne sont pas ce que ressent un cycliste la plupart du temps.
La dépendance va pourtant dans l'autre sens. Précharger toutes les catégories le long d'un parcours de 200 km n'est abordable que grâce à la requête en corridor : une requête par tronçon, toutes les catégories dedans, le filtrage fait dans la base. Avec la chaîne de rectangles, la même gourmandise aurait représenté des dizaines de requêtes par tronçon, et nous n'aurions jamais osé. Le cache, c'est ce que la requête rapide nous a offert.
Compter sans récupérer
Parfois, on veut savoir ce qui nous attend avant de récupérer quoi que ce soit : 84 cafés, 2 robinets d'eau, pas de carburant du tout. L'application peut le dire d'emblée, et vous décidez ensuite ce qui vaut la peine d'être demandé.
C'est le même corridor, et les mêmes candidats, mais on demande un compte par catégorie au lieu d'une liste de lieux. Aucun point n'est renvoyé, seulement des nombres, et c'est justement l'intérêt : un plafond sur le nombre de lignes renvoyées ne peut pas fausser discrètement un compte quand aucune ligne ne revient. Les catégories sans rien le long du parcours renvoient zéro au lieu de disparaître, parce que « rien ici » et « nous n'avons pas vérifié » sont deux réponses différentes, et l'interface indique laquelle elle a.
Pour les curieux du SQL
Tout ce qui précède, c'est l'idée. Voici la requête, et les quatre choses à savoir à son sujet.
CREATE OR REPLACE FUNCTION pois_along_route(
    route_geojson TEXT, radius_m INTEGER, filters JSONB
) RETURNS TABLE (...) LANGUAGE sql STABLE PARALLEL SAFE AS $
    WITH corridor AS (
        SELECT ST_Subdivide(
            ST_Buffer(
                ST_SetSRID(ST_GeomFromGeoJSON(route_geojson), 4326)::geography,
                radius_m
            )::geometry,
            64) AS cell
    ),
    candidates AS (
        SELECT DISTINCT p.osm_type, p.osm_id, p.geom, p.tags, p.osm_timestamp
        FROM pois p
        JOIN corridor c ON p.geom && c.cell AND ST_Intersects(p.geom, c.cell)
    )
    SELECT osm_type, osm_id, ST_Y(geom), ST_X(geom), tags, osm_timestamp
    FROM candidates
    WHERE poi_matches_filters(tags, filters);
$;
4326, c'est la latitude/longitude ordinaire. Chaque système de coordonnées a un numéro, et 4326 est celui que le monde entier utilise pour les degrés de latitude et de longitude : c'est ce que donne un GPS et ce qu'on trouve dans un fichier GPX. ST_SetSRID dit à PostGIS que c'est bien la nature des nombres reçus, parce que le GeoJSON porte les coordonnées mais pas le système.
Buffer en mètres, comparaison en degrés. La bande doit être dessinée en mètres, parce que le rayon est en mètres et que l'import couvre la planète entière : un buffer en degrés réglé pour l'Oxfordshire sort à peine moitié moins large d'est en ouest à Tromsø, comme le montrent les deux bandes du schéma ci-dessus. Du nord au sud, rien ne change, un degré de latitude ayant partout la même longueur, donc la bande sort écrasée plutôt qu'étroite. Mais la comparaison doit se faire de géométrie à géométrie, sinon l'index ne s'applique pas. Donc on dessine la bande en geography, on reconvertit le résultat, et on compare en geometry.
::geography est un cast (en SQL, la conversion d'une valeur d'un type à un autre), et c'est le même que dans la requête simple plus haut, qui fait le travail que montre le schéma de Tromsø.
Découper la bande, c'est toute l'astuce. Un corridor de 200 km avec son buffer est un seul polygone énorme avec le même rectangle englobant inutile, donc le tester n'est pas mieux que la version naïve. ST_Subdivide en cellules de 64 sommets au plus donne des centaines de petits polygones aux rectangles serrés, et l'index redevient utile pour chacun d'eux.
Deux tests par cellule, dont un seul coûteux. p.geom && c.cell est la question du rectangle à laquelle répond l'index, c'est elle qui jette la planète ; ST_Intersects est le test exact, et il ne s'exécute que sur ce qui a survécu au premier. Cette paire est tout le mécanisme décrit dans cet article, mis par écrit.
Supprimer les doublons, parce que les tronçons se touchent. Un café pile sur la jonction entre deux tronçons est trouvé deux fois. Un DISTINCT : peu coûteux à corriger, bête de s'en passer.
La requête de comptage, c'est la même chose avec la dernière ligne changée : même corridor, mêmes candidats, count(*) par catégorie au lieu des lignes elles-mêmes.
SELECT cat.key,
       count(*) FILTER (WHERE poi_matches_filters(cand.tags, cat.value))
FROM jsonb_each(categories) AS cat(key, value)
LEFT JOIN candidates cand ON true
GROUP BY cat.key;
Demander au planificateur de montrer son raisonnement
Le SQL dit ce que vous voulez, jamais comment l'obtenir, donc il faut que quelque chose décide du comment : c'est le planificateur. Face à une requête, il recense les façons possibles d'y répondre, estime le coût de chacune et exécute la moins chère. Utiliser un index est l'une de ces façons, et le planificateur ne la choisira que s'il voit comment faire ; sinon il lit la table du début à la fin, ce qu'on appelle un parcours séquentiel.
La conversion ::geography casse cela doublement. La colonne geom est de type geometry, donc la convertir empêche complètement d'utiliser l'index construit dessus : le planificateur n'a rien à interroger. Et même s'il le pouvait, on retombe sur le rectangle, où le rectangle autour d'une ligne de 200 km livre de toute façon un million de candidats.
Vous pouvez demander au planificateur de montrer son raisonnement, avec EXPLAIN, et il est franc sur ce cas-là. Il attribue un coût à chaque façon de répondre : une estimation du travail que demanderait ce plan. Plus c'est bas, mieux c'est. Le nombre est interne, ce ne sont pas des secondes, donc un seul ne vous dit rien, mais deux côte à côte en disent long.
Ces deux plans viennent de l'instance publique de Postpass, qui montre volontiers le raisonnement de son planificateur, pour une version plus simple de cette requête : un cercle autour d'un point, où la même conversion neutralise le même index de la même façon.
| Comment il prévoit de répondre | Coût estimé (plus bas, c'est mieux) |
|---|---|
| Lire la table du début à la fin et mesurer chaque ligne | 4 500 000 000 |
| Vérifier d'abord les rectangles, puis mesurer les survivants | 4 600 |
Même question, mêmes données, même réponse à la fin. Le planificateur s'attend à ce que l'une demande environ un million de fois plus de travail que l'autre, ce qui est sa façon de vous dire qu'il a renoncé à votre index.
Du navigateur à la base de données
Jusqu'ici, il a été question de la forme de la requête, jusqu'au SQL. Cette dernière partie porte sur qui l'écrit, et c'est finalement la plus grande différence entre ce que nous faisons tourner et ce dont il s'inspire.
Le navigateur n'envoie jamais de SQL.
server.js, puis des paramètres liés passés à une fonction qui existe déjà.Ce qui quitte le navigateur, c'est un objet JSON à quatre champs :
{
  "mode": "route",
  "route": [[[51.54, -0.90], [51.53, -0.92], ...]],
  "radius_m": 500,
  "filters": [[{"k": "amenity", "v": "cafe"}],
              [{"k": "amenity", "v": "drinking_water"}]]
}
route est la ligne allégée de « Avant que la requête ne quitte le navigateur ». filters est la liste des catégories : un ou plusieurs groupes par catégorie, parce qu'une catégorie peut correspondre à plusieurs combinaisons de tags. Il n'y a aucune requête là-dedans, seulement quatre valeurs.
nginx est le serveur web placé devant le nôtre. Il gère le TLS (le s de https) et fait le travail ingrat : la requête doit venir d'une page de pitstopper.net, de notre application mobile ou d'une version de développement locale, trois requêtes par seconde avec des pointes à quinze, un corps de 2 Mo au maximum. Un script sans en-tête Origin passe quand même, et c'est à ça que sert la limite de débit. Ensuite, il garde un cache de réponses indexé sur le corps de la requête, ce qui n'est possible que parce que ce corps a une forme fixe. Deux cyclistes qui demandent les mêmes catégories le long du même corridor partagent un seul aller-retour vers la base.
Ce cache peut garder une réponse pendant 24 heures, ce qui semble contredire les mises à jour horaires. Ce n'est pas le cas, parce que chaque mise à jour horaire le vide en dernière étape. Les 24 heures sont un plafond jamais atteint : une recherche répétée a au plus une mise à jour de retard, et le bouton de rechargement par catégorie envoie ?nocache=1 pour contourner complètement le cache.
server.js vérifie la forme et les limites, et honnêtement, c'est tout ce qu'il fait. Le mode est route ou point. Un rayon entre 25 m et 35 km. Au plus 10 000 points répartis sur au plus 32 parcours ; au plus 128 groupes de filtres d'au plus 8 paires de tags ; aucun tag de plus de 256 caractères. Ensuite, il transforme [lat, lon] en [lon, lat] façon GeoJSON et fait un seul appel :
pool.query('SELECT * FROM pois_along_route($1, $2, $3::jsonb)',
           [geojson, radius, filters]);
Ce sont des paramètres liés et non une concaténation de chaînes. L'instruction est une constante écrite dans le fichier et les valeurs voyagent à côté, jamais collées dedans, donc un tag au nom astucieux n'a rien à glisser : aucun moyen de terminer la requête en avance pour en lancer une à soi. Cette astuce, c'est l'injection SQL, et elle vide des bases de données depuis les années 90.
PostGIS fait ensuite tout ce dont parle le reste de cet article. Les cinq fonctions de schema.sql constituent toute la surface de requête : pois_along_route, pois_around_point, pois_count_by_category, ways_along_route et ways_around_point.
Comme l'intermédiaire ne contient rien, ce pourrait être PostgREST ou pg_featureserv à la place, sans que le client ni le SQL ne s'en aperçoivent. Ce n'est pas de la propreté pour le plaisir. C'est ce qui nous a permis de faire tourner tout le backend face à l'ancien chemin Overpass sur le site de préproduction, même client et mêmes catégories derrière un interrupteur, et d'obtenir des chiffres plutôt que des opinions.
Ce qui n'est pas le fonctionnement de Postpass, et c'est voulu
Postpass prend du SQL. Vous lui envoyez une instruction par POST, il l'exécute, vous récupérez du GeoJSON. C'est tout son intérêt, et c'est exactement pour cela que c'était le bon outil pour faire un prototype : nous pouvions essayer une requête en corridor sur un miroir de la planète entière sans rien déployer du tout.
Nous l'utilisons toujours, et pas comme pièce de musée. L'instance publique de Geofabrik est le niveau vers lequel nous basculons quand nos deux nœuds sont en panne, et depuis la suppression de la distribution vers Overpass en août 2026, il n'y a plus rien derrière : Postpass est le dernier rempart entre un cycliste et pas de réponse du tout.
Les deux formes du schéma sont donc actives dans le même navigateur. Si notre serveur répond, le client a envoyé des paramètres. Sinon, le même client construit un SELECT et l'envoie à Geofabrik. Une recherche, deux idées complètement différentes de qui écrit la requête, choisies à l'exécution selon que notre matériel tourne ou non.
Le compromis mérite d'être exposé franchement.
Ce que nous perdons, c'est la généralité. Toute question à laquelle nous n'avons pas pensé à l'avance demande une nouvelle fonction et un déploiement, là où un utilisateur de Postpass écrirait simplement un autre SELECT.
Ce que nous gagnons ne fonctionne que quand la forme est connue à l'avance. Le planificateur voit toujours les cinq mêmes instructions, donc un plan peut être vérifié une fois puis considéré comme fiable, au lieu d'être recalculé à chaque requête à partir du SQL qui arrive. Le cache de réponses peut s'indexer sur le corps. Et les limites ci-dessus sont applicables, parce que « au plus 10 000 points » est une chose qu'on peut dire d'un champ, pas d'une requête.
Ce que ça coûte à faire tourner
Mesuré le 12 septembre 2026 sur l'un de nos deux nœuds (srv01, qui répond aux requêtes sous le nom poi01), avec un import de la planète et notre liste de tags autorisés. Pas estimé, et plus gros qu'on ne l'attendrait d'un article sur des points d'intérêt, pour une raison qui vaut d'être vue.
| Lignes de POI | 75,7 M |
| Lignes de ways | 266 M |
| Base de données sur disque, index compris | 219 Go |
| Stockage flat-nodes d'osm2pgsql | 106 Go |
| PBF de la planète filtré | 33 Go |
| Serveur Node, mémoire utilisée | 49 Mo |
La base se répartit à peu près ainsi, chaque chiffre incluant les index de la table : ways fait 102 Go, la table intermédiaire planet_osm_ways d'osm2pgsql encore 91 Go, et pois (la table dont parle tout cet article) seulement 24 Go. La moitié POI est la moitié bon marché. C'est la géométrie complète des routes qui coûte, et nous l'avons payée délibérément, pour les trois fonctionnalités qu'un centroïde ne peut pas servir.
Un way atterrit dans les deux tables. pois contient son centroïde, ce qui convient pour un café dans un bâtiment, et ways sa géométrie complète, la seule chose qui puisse répondre à « où le revêtement change-t-il » ou « cale ce point sur une route ». Un centroïde ne peut pas dessiner un tunnel.
Les mises à jour tournent toutes les heures ; une reconstruction complète à partir de la planète tourne tous les mois. La ligne de provenance porte les deux horodatages, parce que « de quand date la base » et « de quand date la modification la plus récente » sont deux questions différentes, et qu'un chien de garde de fraîcheur a besoin de la première.
Si vous faites tourner Postpass
Soyons clairs sur ce que nous avons pris et pas pris : l'idée vient de Postpass, le code non. Nous ne faisons tourner aucun Postpass, et notre serveur n'en est pas un fork. Ce que nous avons copié, c'est la recette que tout le monde peut copier (osm2pgsql vers PostGIS, HTTP devant), puis nous avons écrit quelques centaines de lignes pour servir les cinq questions que nous posons vraiment. Si vous avez besoin de l'outil généraliste, faites tourner Postpass. Il est bon, et écrire le vôtre ne vaut la peine que si vos besoins sont plus étroits que ceux du projet, ce qui concerne moins de monde qu'on ne croit.
Quel que soit votre choix, mettez le stockage flat-nodes d'osm2pgsql sur votre disque le plus rapide. C'est un tableau plat indexé par identifiant de nœud OSM, 106 Go en tout, et c'est ce qui permet à l'import de ne pas garder en RAM les positions des nœuds de la planète. Nous avons un jour déplacé le nôtre sur un NVMe en USB par erreur, et les mises à jour horaires sont passées de 33 secondes à 17 minutes.
Si vous voulez des corridors de parcours sur votre propre instance, prenez ST_Subdivide sur un buffer en geography et laissez le reste. Ce seul appel fait la différence entre une requête qui se lit correctement et une requête qui tourne. Tout le reste ici relève de nos goûts particuliers en matière de filtres de tags.
Un autre point vaut une heure de votre temps si vous migrez depuis Overpass plutôt que de partir de zéro : notre format de réponse est volontairement compatible avec Overpass, {elements: [...]} avec les tags bruts, les nœuds portant lat/lon et les ways un point central. Le client qui parlait à Overpass a eu besoin d'un adaptateur et d'environ un après-midi.
Voir le corridor par vous-même
Tout ce qui est illustré plus haut correspond à Système → Afficher zone de recherche dans PitStopper, sur n'importe quel parcours chargé. Il dessine des cercles exacts en mètres le long de la ligne allégée, au rayon en cours, donc faire glisser le curseur de rayon redessine la vraie zone de requête. Nous l'avons construit pour déboguer ce travail et l'avons laissé, parce qu'une requête spatiale qu'on ne peut pas voir est une requête spatiale sur laquelle on fait des suppositions.