Vertaald uit het Engels.
Als je PitStopper vraagt om de cafés, waterkranen, winkels of schuilhutten langs een route te tonen, moet het een vraag beantwoorden die eenvoudig klinkt, maar het niet is:
Welke plekken liggen binnen 500 meter van deze lijn van 200 km?
Niet bij een punt. Niet binnen een rechthoek. Langs een kronkelende lijn, over 200 km, met het antwoord binnen voordat de fietser zich begint te vervelen.
Die vraag heeft één goed antwoord en een paar aannemelijke slechte. We hebben acht maanden met een van de slechte gedraaid, en de voor de hand liggende manier om dat op te lossen blijkt er nog een te zijn. Deze post gaat over hoe het goede antwoord werkt: wat PostGIS is, waarom de voor de hand liggende query traag blijkt, en het kleine trucje dat de uiteindelijke versie snel maakt.
Eerst: wat PostGIS is
Drie lagen, en alleen de middelste is onbekend.
PostgreSQL is een gewone database, het soort dat achter de meeste websites zit. Het bewaart rijen gegevens en laat je erin zoeken en filteren.
PostGIS is een uitbreiding voor PostgreSQL die het leert omgaan met vormen. Een kolom kan een punt, een lijn of een vlak bevatten, net zoals een andere kolom een naam of een prijs bevat, en een paar honderd nieuwe functies laten je er vragen over stellen: wat ligt bij wat, wat kruist wat, hoe ver liggen twee dingen uit elkaar.
PitStopper gebruikt de twee samen om een doorzoekbare kopie van OpenStreetMap bij te houden, en vraagt die waar dingen liggen ten opzichte van je route.
Concreet is een café in onze database een rij die er ongeveer zo uitziet:
name      The Coffee House
location  POINT(-0.9016 51.5372)
tags      amenity=cafe
En een route die je hebt geladen, is ook een vorm:
geometry LINESTRING(-0.89 51.53, -0.91 51.54, ...)
Je route wordt niet bij de cafés bewaard: ze komt binnen met de vraag en is daarna weer weg. Maar zodra beide in dezelfde taal uitgedrukt zijn, kun je één vraag stellen: welke van die punten liggen binnen 500 meter van deze lijn? Dat is het hele idee, en alles hieronder gaat over hoe je dat snel maakt.
Waar de gegevens vandaan komen
OpenStreetMap is een gratis kaart van de wereld die iedereen kan bewerken, de Wikipedia van de kaarten. Meer dan twee miljoen mensen hebben de wegen, paden, cafés, bankjes en waterkranen in hun buurt toegevoegd. Alles erin wordt beschreven met eenvoudige labels van sleutel en waarde, tags genoemd, dus een café is amenity=cafe en een drinkfontein is amenity=drinking_water, en daarop zoeken we.
Wat hier telt, is dat je de hele database kunt downloaden. We vragen het niet beleefd aan de kaartdienst van iemand anders; we hebben onze eigen kopie en vragen die wat we maar willen.
Het addertje is dat een kopie veroudert, en OSM staat nooit stil: miljoenen bewerkingen per dag, elke dag. Daarom draaien onze updates elk uur, en niet wanneer we er toevallig aan denken.
Waarom niet gewoon OpenStreetMap vragen?
Een terechte vraag, en lange tijd deden we precies dat.
OpenStreetMap zijn de gegevens. Ze bevragen is een apart probleem, en Overpass is daar het gebruikelijke antwoord op. Daar is PitStopper mee begonnen, en het grootste deel van die tijd op onze eigen hardware: we draaiden acht maanden lang onze eigen Overpass-instantie, netjes bijgehouden.
Het werkte. Het was alleen traag, en hoe langer de route, hoe trager, door de vorm van de vraag en niet door de hardware. Overpass beantwoordt "wat zit er in deze rechthoek" goed. Je kunt het naar een lijn vragen (around: neemt een hele polylijn, niet alleen een punt), maar op een route met duizenden punten is die query zo duur dat hij onbruikbaar wordt, en het was voor ons goedkoper om in plaats daarvan veel rechthoeken te sturen. Dus deden we dat: één verzoek per rechthoek, en dan nog eens voor elke categorie.
De gegevens zelf bijhouden was nooit het probleem. Wat veranderde, is wat we eraan konden vragen. Zet dezelfde OpenStreetMap-gegevens in PostGIS en je kunt de query vormgeven naar wat PitStopper echt nodig heeft, in plaats van hem op te bouwen uit de ene vraag die de API kan beantwoorden.
Postpass is de tussenstap die ons liet zien dat dit de moeite waard was. Het zet OpenStreetMap in PostGIS en biedt SQL aan via HTTP: je stuurt het een query in plaats van parameters, en je krijgt GeoJSON terug, een eenvoudig tekstformaat om vormen te beschrijven. Geen radius=, geen vaste set endpoints, gewoon SQL op een spiegel van de hele planeet. Door die openheid wordt een soort vraag waar Overpass mee worstelt, heel gewoon.
Drie namen komen vanaf hier steeds terug, en ze verschillen één letter en één idee:
- Overpass: de vertrouwde manier om OpenStreetMap vragen te stellen. Goed in "wat zit er in deze rechthoek". Wat we onze eerste acht maanden draaiden.
- Postpass: dezelfde gegevens in PostGIS, die antwoord geven op SQL die via HTTP binnenkomt. Waar de corridorquery vandaan kwam, en nog altijd het laatste wat overeind blijft als onze beide machines plat liggen.
- Onze eigen server: hetzelfde recept, met de SQL verhuisd naar de database, zodat de browser in plaats daarvan getallen stuurt. Wat vandaag antwoordt.
Alles begint met een rechthoek
Een ruimtelijke database is om één reden snel. Ze vergelijkt je query niet met elke rij. Ze houdt voor elk object een bounding box bij, een eenvoudige rechthoek eromheen, en met de ruimtelijke index gooit ze in één stap alles weg waarvan de rechthoek de jouwe niet raakt. Alleen wat overblijft, moet door de exacte, dure geometrische test.
Die index heeft een naam die je in elke discussie over PostGIS tegenkomt: GiST. Het is de index die PostGIS op een geometriekolom bouwt, en hij maakt van "welke rechthoeken overlappen deze rechthoek" één opzoeking in plaats van 75 miljoen vergelijkingen. Als deze post "de index" zegt, bedoelt hij die.
Heel grof gezegd kan de index zeggen: dit café ligt duidelijk nergens in de buurt van het gebied dat ons interesseert, dus negeer het.
De grootte van je rechthoek bepaalt dus alles.
Vraag "wat ligt binnen 500 m van dit café" en je rechthoek is een vierkant van een kilometer breed. De index gooit de hele planeet weg en geeft veertig kandidaten terug. Vraag "wat ligt binnen 500 m van deze route van 200 km" en je rechthoek is de kleinste rechthoek waar de hele route in past, een provincie of twee. De index gooit nog altijd weg, maar een rechthoek van die grootte houdt ongeveer een miljoen kandidaten over, en elk daarvan moet een voor een door de exacte test.
Dat ene feit verklaart zowel de aanpak die we eerst gebruikten als de query die je er vanzelf voor in de plaats zou schrijven.
Wat we eerst gebruikten: overal rechthoeken
Bedek de route met een ketting van rechthoeken en bevraag ze een voor een. Dat waren die acht maanden. Het werkt, en het verspilt ontzettend veel, want een rechthoek rond een diagonaal stuk weg is vooral weiland, en een route die bochten maakt, heeft veel rechthoeken nodig. Overpass reageert ook slecht op één query met meer dan een handvol losse tagfilters, dus we stuurden nooit meer dan zes categorieën tegelijk: het waren rechthoeken maal categorieën, en een lange rit werd tientallen verzoeken, waarvan er een aantal een time-out kregen.
Het loont om duidelijk te zijn over waar de tijd heen ging, want het lag niet aan de server. Onze instantie was van ons, ze werd bijgehouden en ze hoefde met niemand om capaciteit te vechten. De kosten zaten in de vorm van de vraag: tientallen keren heen en terug per zoekopdracht, en elke keer kwamen er dingen terug waar de fietser nooit langs zou komen.
De corridor is de vorm die je echt bedoelt
We willen eigenlijk niet in een rechthoek zoeken. En ook niet in honderd kleine rechthoeken.
Wat we echt bedoelen, is: geef me alles binnen deze strook die de route volgt.
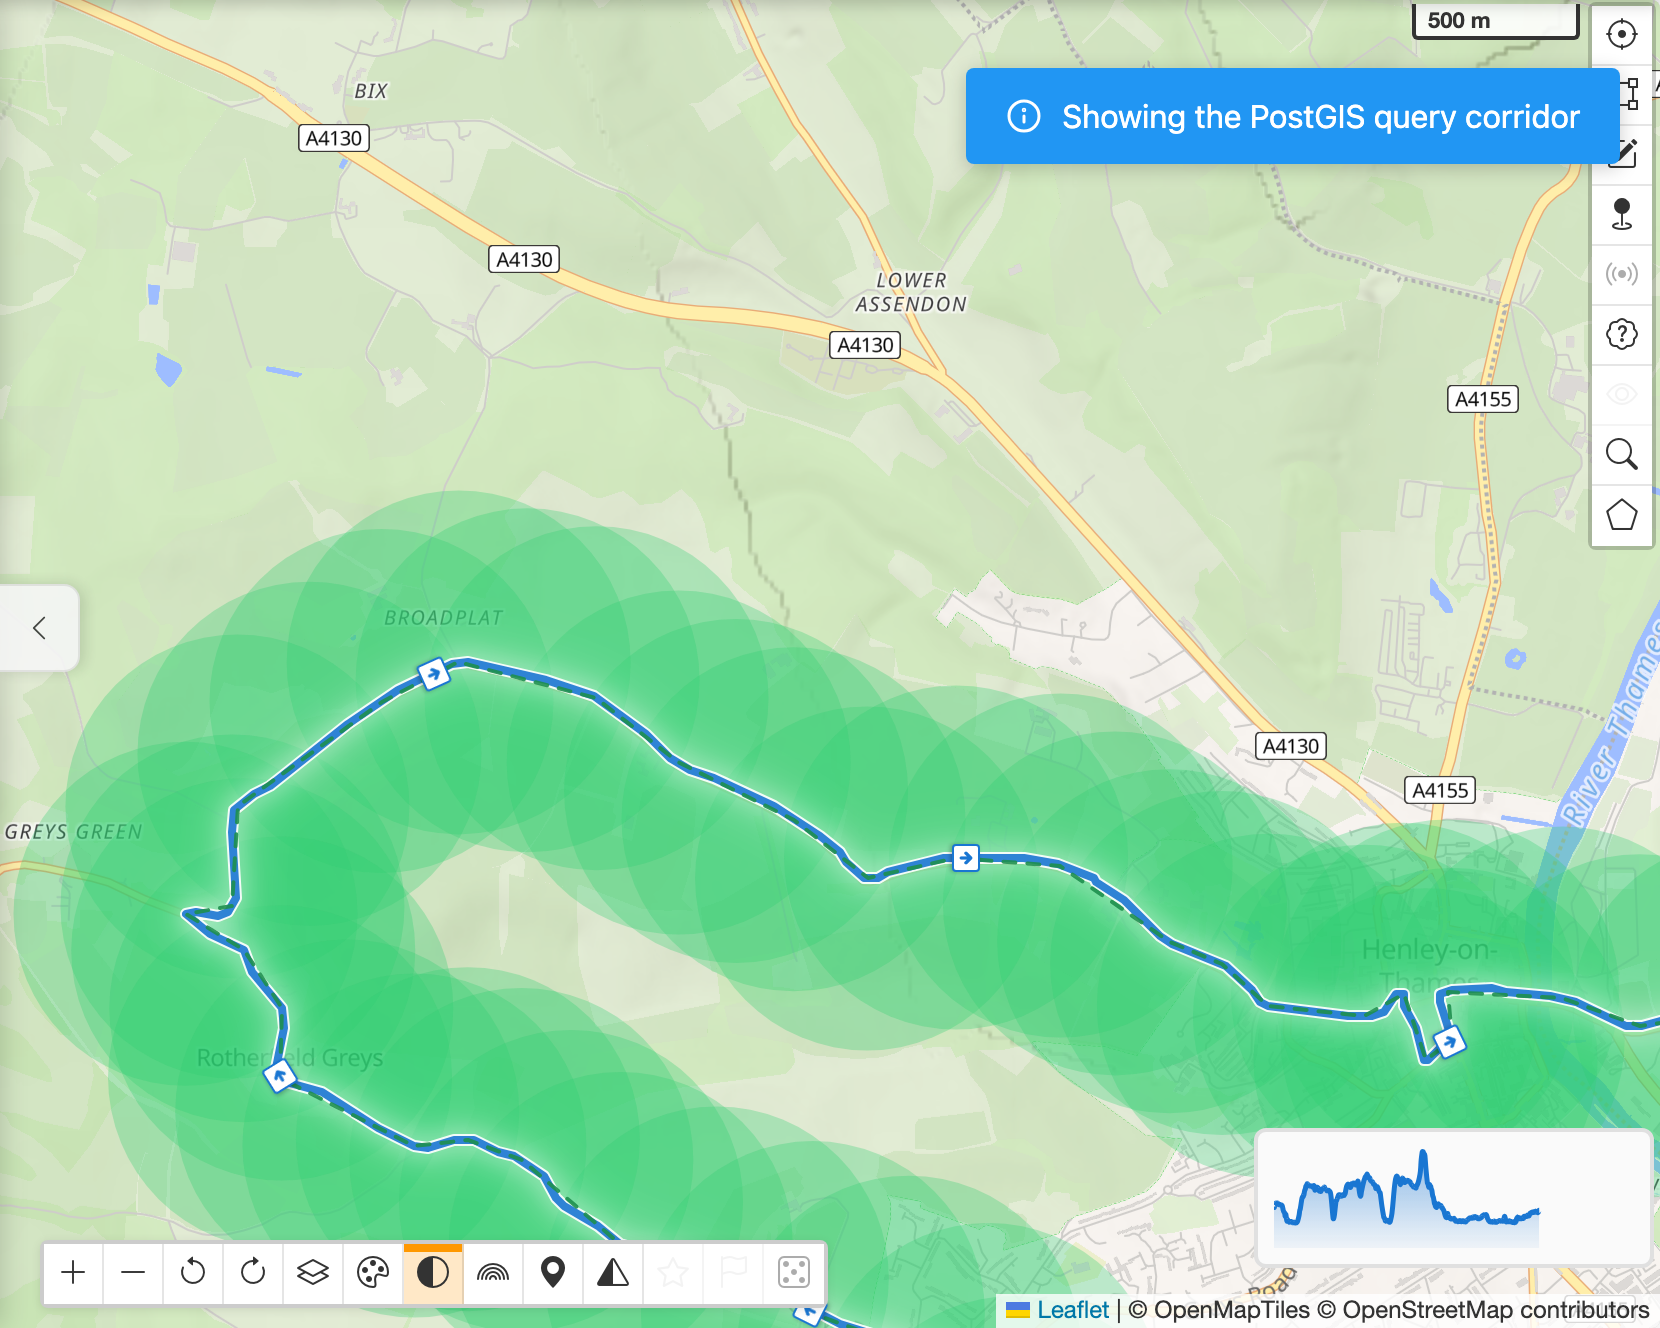
Dat is een corridor. Is de route 200 km lang en de zoekstraal 500 meter, dan is de corridor gewoon de route met aan weerszijden 500 meter erbij. PostGIS tekent die vorm voor ons, met een functie die ST_Buffer heet.
Het belangrijke is dat dit geen benadering van de route is. Het is het zoekgebied dat we echt bedoelen. Hier is er een, getekend door de app met de straal die de query echt gebruikt:
En hetzelfde beeld na het zoeken, met de punten die de corridor teruggaf:
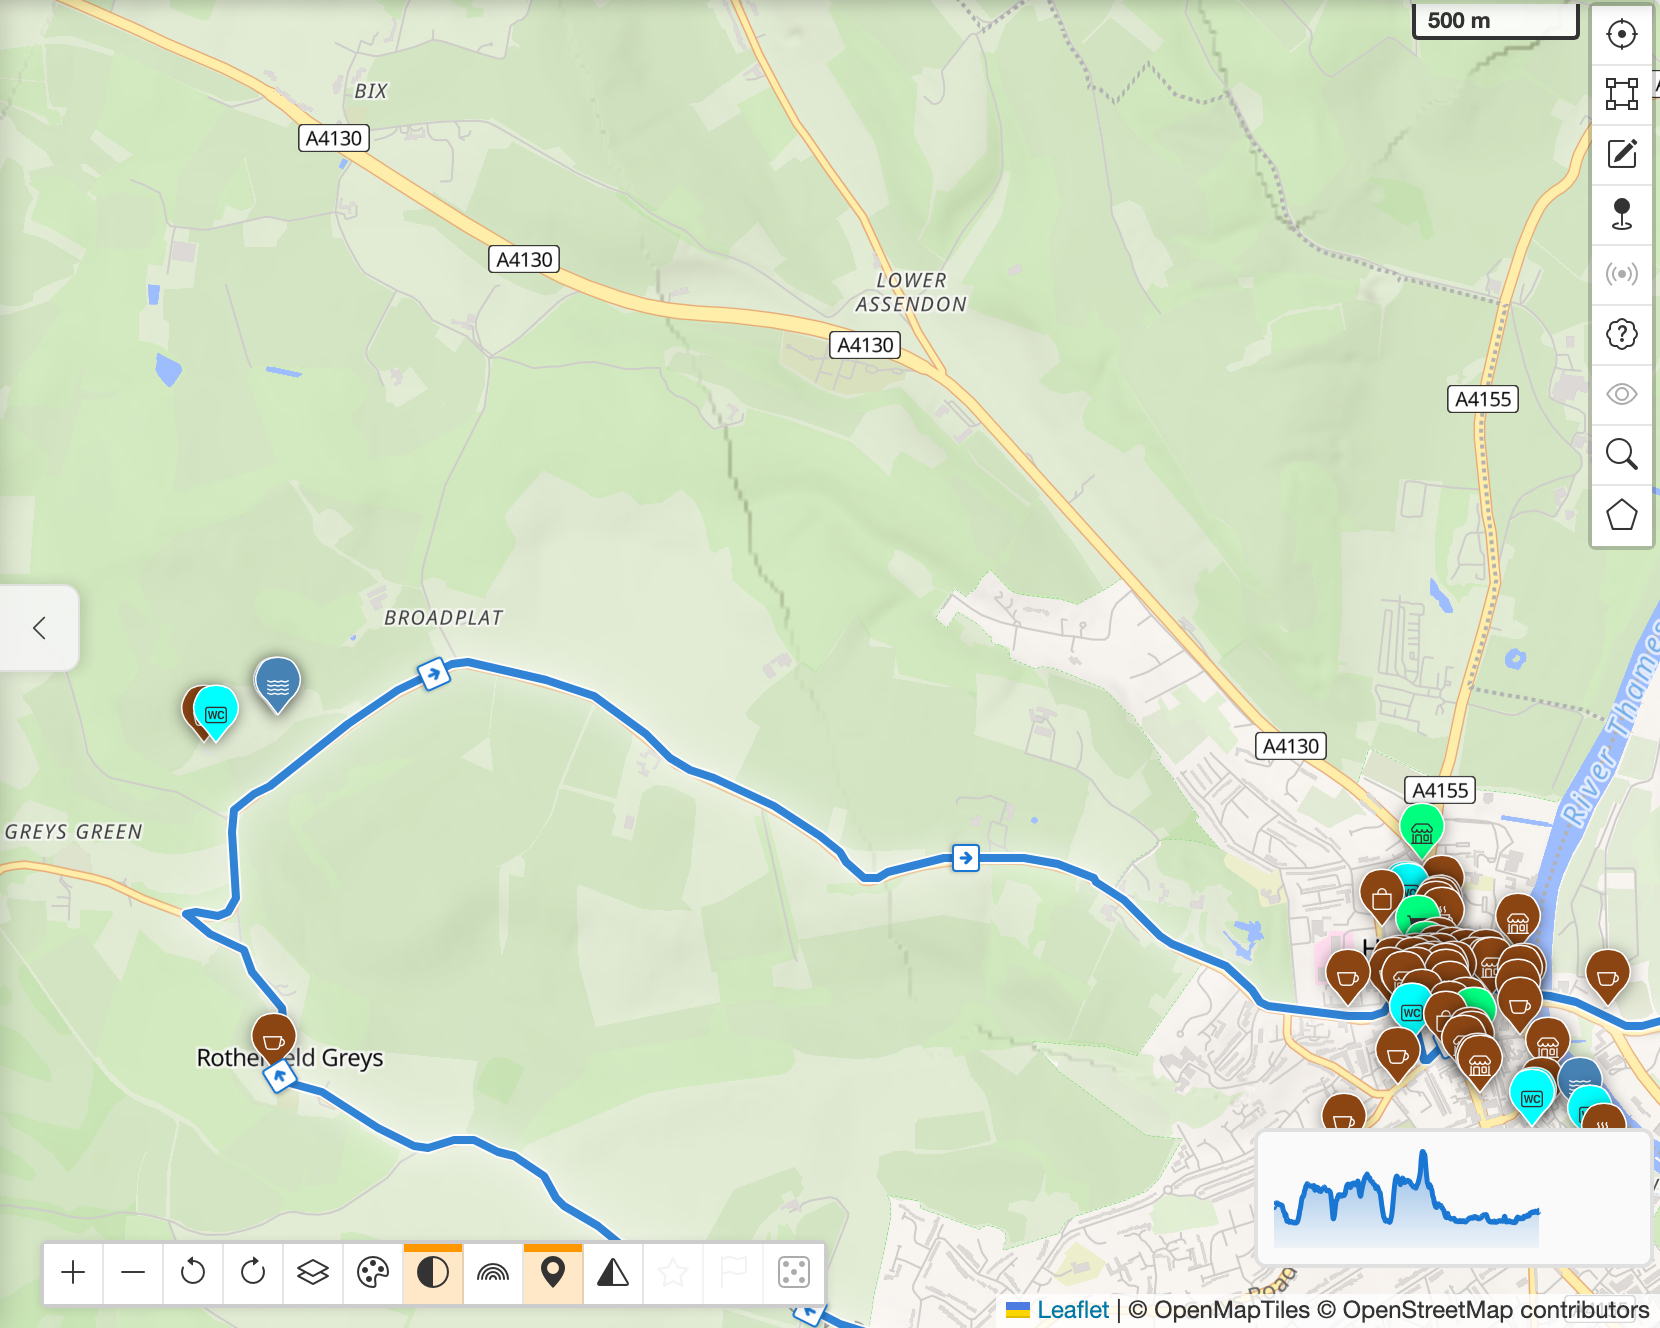
De groep in Henley is wat je zou verwachten. Het paar bij Broadplat is het interessante: een paar honderd meter van de weg, niets eromheen, precies wat een slordige test op "dicht bij de route" weggooit. Het is ook het enige water op acht kilometer.
De query die je eerst schrijft
Stap over op PostGIS en de corridor is niet langer een vorm die je met rechthoeken moet benaderen. Je kunt er gewoon om vragen:
SELECT * FROM pois
WHERE ST_DWithin(geom::geography, route::geography, 500);
In gewone taal: geef me elke plek die binnen 500 meter van deze route ligt.
Als SQL niet je taal is, dit zijn de onderdelen:
poisis onze tabel met plekken, één rij per café, kraan, bankje of schuilhut. 75 miljoen ervan.geomis waar een plek ligt, enrouteis de lijn die je hebt geladen.ST_DWithinis de vraag: liggen deze twee vormen binnen 500 van elkaar? Bijna elke functie in PostGIS heetST_iets, voor "spatial type".::geographyzorgt ervoor dat500500 meter betekent en niet 500 graden. Dat is belangrijker dan het lijkt, en aan het einde staat een stuk voor wie dat verhaal wil horen.
Correct, leesbaar, en een volledige tabelscan verkleed als ruimtelijke index. "Elke plek die we hebben" is 75 miljoen afstandsberekeningen tegen een lijn van 200 km.
Er zijn twee dingen mis mee, en het tweede is waar deze post over gaat. Het directe probleem is die ::geography: een kolom onderweg omzetten betekent dat de index op die kolom helemaal niet gebruikt kan worden, dus de query komt nooit bij de rechthoekfase. Los dat op en je stuit op de rechthoek: de rechthoek rond een lijn van 200 km levert nog altijd het grootste deel van de database aan de exacte test. De omzetting is een fout die je in een minuut verbetert; de rechthoek is de vorm van het probleem. Het stuk over de planner hieronder heeft de bewijzen voor allebei.
De oplossing: hak de strook in tegels
Een corridor van 200 km is zelf een enorme vorm, en de rechthoek eromheen is dezelfde provincie of twee als daarnet. Dus hakken we hem in korte stukken, met ST_Subdivide.
Zie het als de database een kaart geven van kleine tegels in plaats van één enorm vel. Elke tegel is klein, dus de rechthoek eromheen is klein, dus de index is weer nuttig: voor elke tegel kan hij bijna de hele database in één stap weggooien. Hetzelfde antwoord, gevonden met een fractie van het werk.
Het onderscheid om te onthouden: we hakken de corridor in stukken voor de database, niet omdat we de route benaderen. De strook blijft de strook.
Deden we dit niet al met rechthoeken?
Snel gezegd klinken de twee aanpakken als twee keer hetzelfde idee: hak de route in stukken, vraag naar elk stuk. Het verschil zit in wat de stukken zijn, en wie ze ooit te zien krijgt.
| Rechthoeken, via Overpass | Corridorcellen, binnen PostGIS |
|---|---|
| Rechthoeken worden over de route gelegd | De corridor volgt de route al |
| De rechthoek is de vraag | De cel is hoe de vraag aan de index gesteld wordt |
| Over het netwerk gestuurd, één verzoek per stuk | Verlaten de database nooit |
| Wat in de rechthoek zit, komt terug | Kandidaten worden eerst tegen de echte strook getest |
| Een café drie weilanden verderop is een resultaat | Een café drie weilanden verderop valt af voor het antwoord vertrekt |
| Tientallen verzoeken, sommige met een time-out | Eén verzoek, alle categorieën tegelijk |
De rechthoeken van Overpass waren de vraag: een rechthoek ging over het netwerk en wat erin zat, kwam terug, ook het café op drie kilometer van de weg. De corridorcellen zijn leidingwerk dat niemand ooit ziet: elke cel levert een handvol kandidaten op, en elke kandidaat wordt tegen de strook zelf getest voor het antwoord de database verlaat. Het in stukken hakken bleef; wat in stukken gehakt werd, en wat terugkwam, veranderde allebei.
Wat er echt gebeurt als je zoekt
your route
    |  thinned to a few hundred points
    v
sent as a list of points
    |  turned into GeoJSON on the server
    v
a line the database understands
    |  ST_Buffer, 500 m
    v
a corridor
    |  ST_Subdivide
    v
short sections
    |  spatial index, one step per section
    v
candidate places
    |  tested against the real corridor, then the tag filters
    v
results
De meeste zoekopdrachten komen nooit verder dan de eerste regel daarvan, omdat het antwoord al in de browser zit. "De cache die dit allemaal verbergt", hieronder, legt uit waarom.
Wat dit betekent voor een fietser
Denk terug aan die twee kranen bij Broadplat: een paar honderd meter van de weg, het enige water op acht kilometer, en precies wat een rechthoek in de buurt van de route wel of niet vangt, afhankelijk van waar die rechthoek toevallig ophield. De echte vraag stellen (alles binnen een strook van 500 meter aan weerszijden van de lijn die ik rijd) is hoe je ze terugkrijgt. Daar dient dit allemaal voor. De rest is wat het mogelijk maakt:
- Lange routes betekenen niet langer tientallen aparte zoekopdrachten.
- Alle categorieën worden samen doorzocht in plaats van met één verzoek per categorie.
- Het zoekgebied volgt de route in plaats van een verzameling grote rechthoeken in de buurt ervan te zijn.
- Het filteren gebeurt in de database, dus wat over het netwerk gaat, is het antwoord en niet de grondstof.
- Dezelfde aanpak werkt voor een avondlusje van 20 km en een tocht van 700 km.
Vraag alles binnen 500 meter van een route van 700 km en dat is één vraag, één keer gesteld.
De cijfers. Twee runs op dezelfde dag, 11 juli 2026, met de testopstelling in de repo (tests/e2e/poi-backend-compare.diag.spec.js) tegen staging. Het is belangrijk welke welke is.
De eerste is degene die de overstap rechtvaardigde. Die zette het oude Overpass-pad tegenover een corridorquery in PostGIS, aan beide kanten zonder cache:
| de zoekopdracht | Overpass | PostGIS-corridor |
|---|---|---|
| 6 km, 8 categorieën | 4,3 s | 0,19 s |
| 180 km, 8 categorieën | 9,7 s | 0,66 s |
| 180 km, 20 categorieën op 1 km | 20,1 s | 0,85 s |
| 700 km, 8 categorieën | nooit klaar, time-out na 120 s | 2,8 s |
| 700 km, 20 categorieën op 1 km | nooit klaar, time-out na 120 s | 4,1 s |
Vijftien tot vierentwintig keer sneller op de zoekopdrachten die klaar raakten, en twee die niet langer mislukten. De PostGIS-kolom daar is de publieke Postpass van Geofabrik, want op dat moment hadden we nog niets eigens gebouwd. (De volledige tabel in de repo heeft elf rijen en een grotere spreiding, van 3x bij een zoekopdracht rond een punt in een druk gebied van 5 km tot 34x bij een korte route met twintig categorieën.)
Later die avond, toen onze eigen server er was, zette een tweede run ze alle drie naast elkaar. Onze node versloeg de publieke instantie op elke rij, en dat is het argument om je eigen te draaien: hetzelfde idee, maar de vragen liggen vooraf vast en de gegevens zijn gefilterd op wat we echt vragen.
| de zoekopdracht | publieke Postpass | onze eigen server |
|---|---|---|
| 6 km, 1 categorie | 157 ms | 79 ms |
| 180 km, 1 categorie | 909 ms | 182 ms |
| 180 km, 8 categorieën | 685 ms | 241 ms |
| 180 km, 20 categorieën op 1 km | 933 ms | 312 ms |
| parkeren binnen 170 m, Reading | time-out na 8 s | 206 ms |
Twee rijen daar verdienen eerder een kanttekening dan opschepperij.
Eén categorie op de route van 180 km kwam trager terug dan acht op dezelfde route, en dat kan niet kloppen met het werk dat gedaan wordt. De publieke instantie is een gratis gedeelde dienst zonder antwoordcache, dus haar cijfers schommelen met wat iedereen er op dat moment aan vraagt. Lees die kolom als een grootteorde en niets fijner. De ruis is deel van het argument om je eigen te draaien; het is geen bewijs dat wij hier vier keer beter in zijn.
De parkeerrij is ook geen fout in Postpass, en het is de nuttigste regel in de tabel. amenity=parking is een van de grootste tagsets in OpenStreetMap: we hebben er 6.779.228, en ze gewoon tellen, zonder enige geografie, kost onze eigen node ongeveer drie seconden. Het antwoord op "parkeerplaatsen binnen 170 meter van dit punt in Reading" is twee, in 206 ms. Alles draait om de andere 6.779.226 met een rechthoek weg te gooien voordat er ook maar naar een tag gekeken wordt, en dat is het onderwerp van deze hele post, en precies wat de omzetting naar ::geography stilletjes verhindert.
Twee runs op één dag, dus lees het allemaal als grootteordes en niet als benchmarks. De vorm is wat telt: de zoekopdracht ontplofte niet langer met de lengte van de route.
De strook is echt in meters breed
Omdat de strook in meters getekend wordt en niet in graden, klopt de breedte op elke breedtegraad, en de debug-overlay tekent hem op dezelfde manier. Wat je op de kaart ziet, is de query.
geography zorgt ervoor dat 500 overal 500 meter betekent.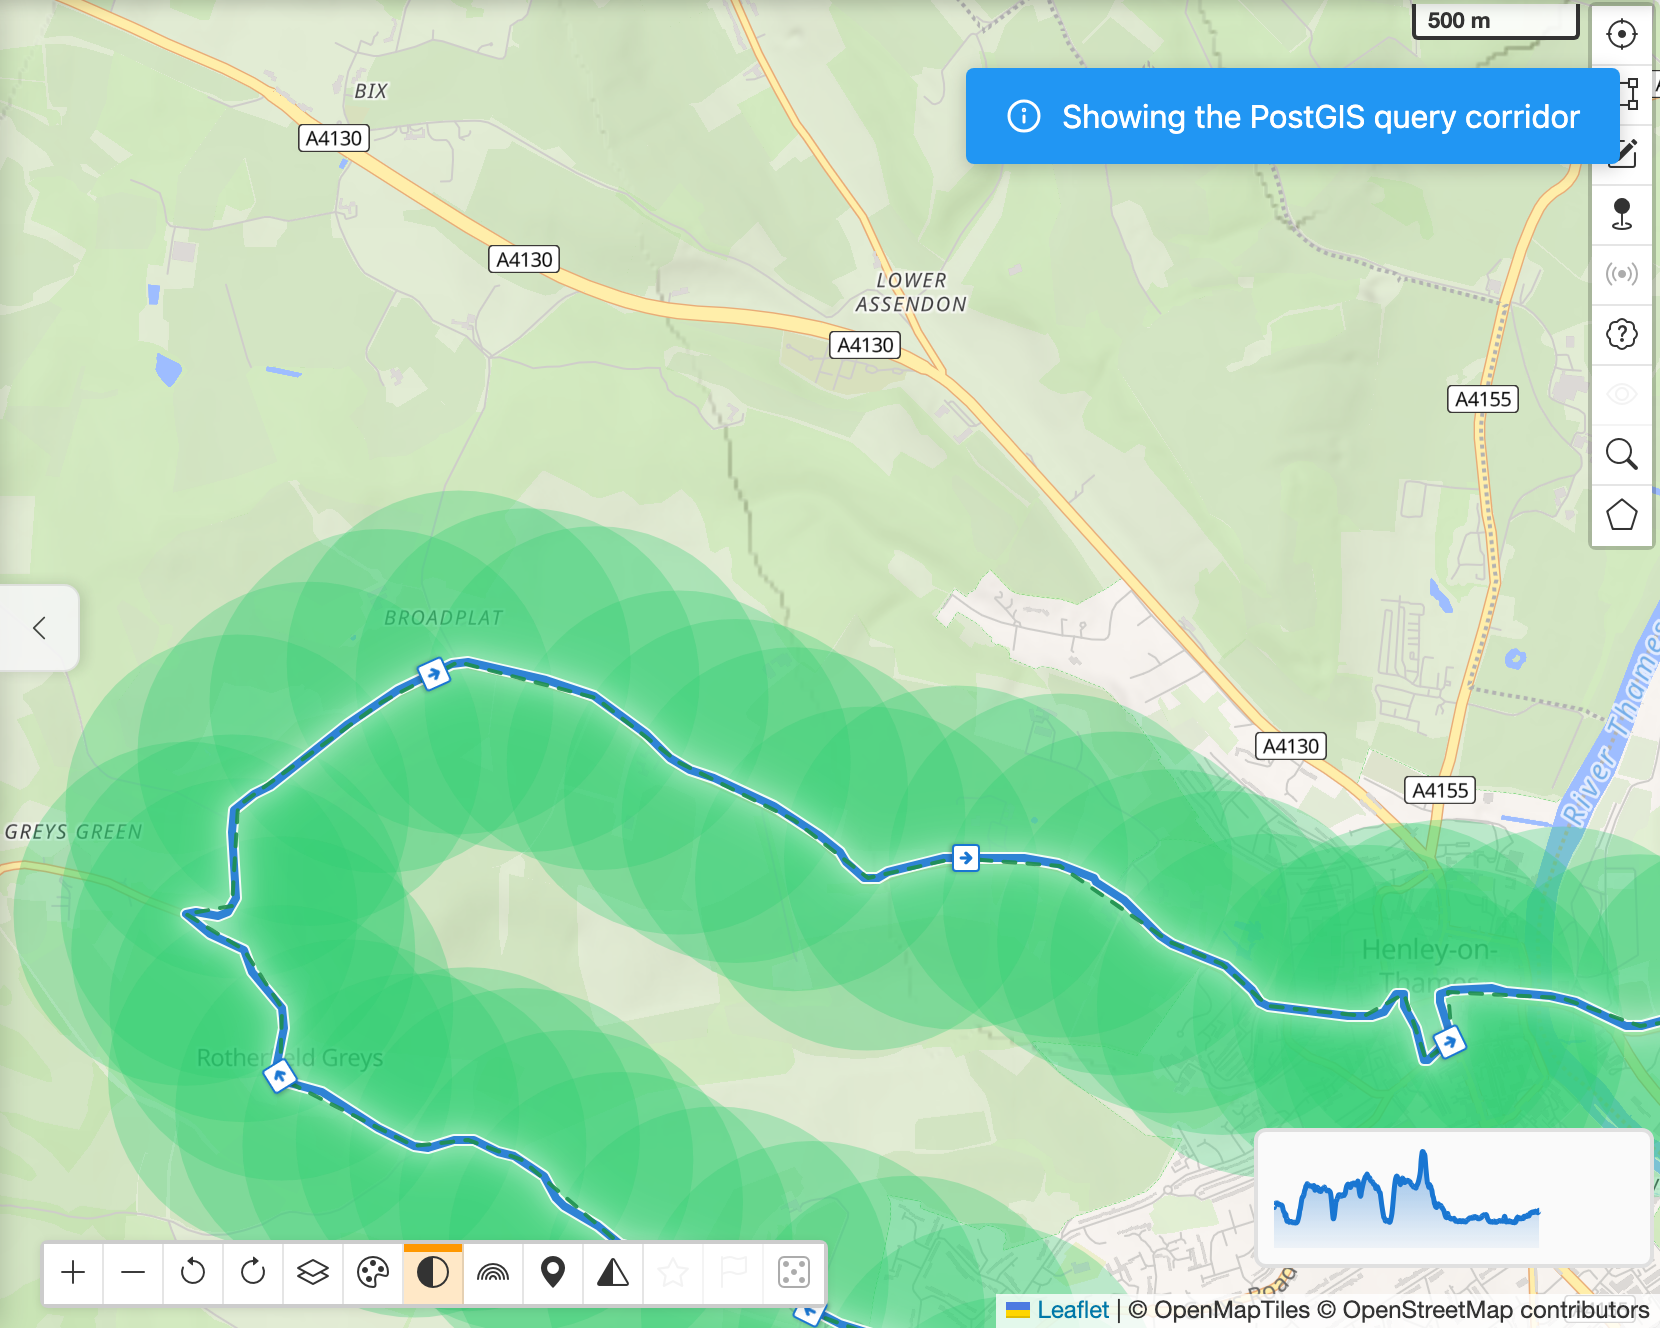
Dat is hetzelfde beeld bij 100 m in plaats van 500 m. Aan de query verandert niets behalve het getal.
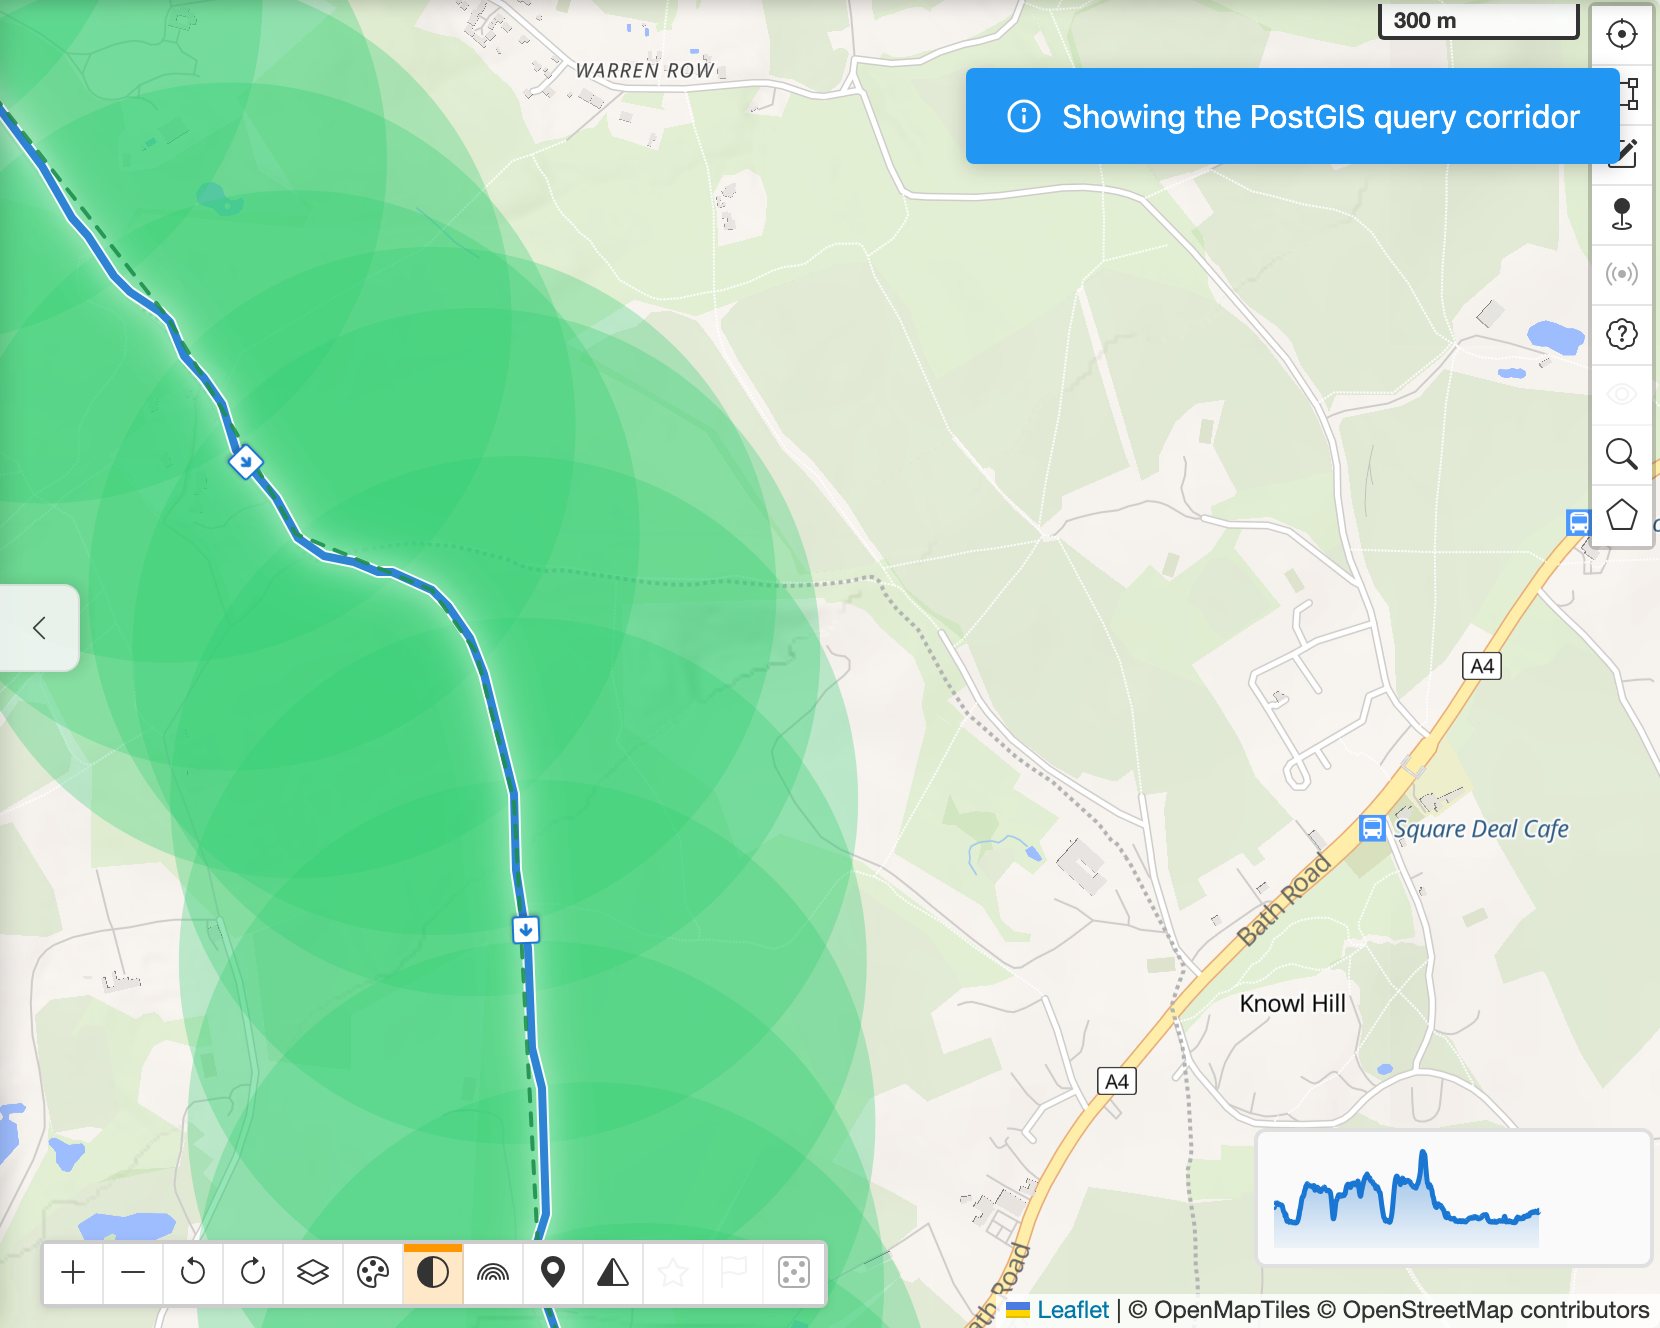
Dezelfde overlay in een bocht. De rand van de strook houdt de hele bocht door dezelfde afstand tot de weg, en dat is wat "binnen 500 meter van de route" echt betekent. Alles ten oosten ervan valt hier gewoon buiten de vraag: de weilanden, Knowl Hill, de A4 erdoorheen.
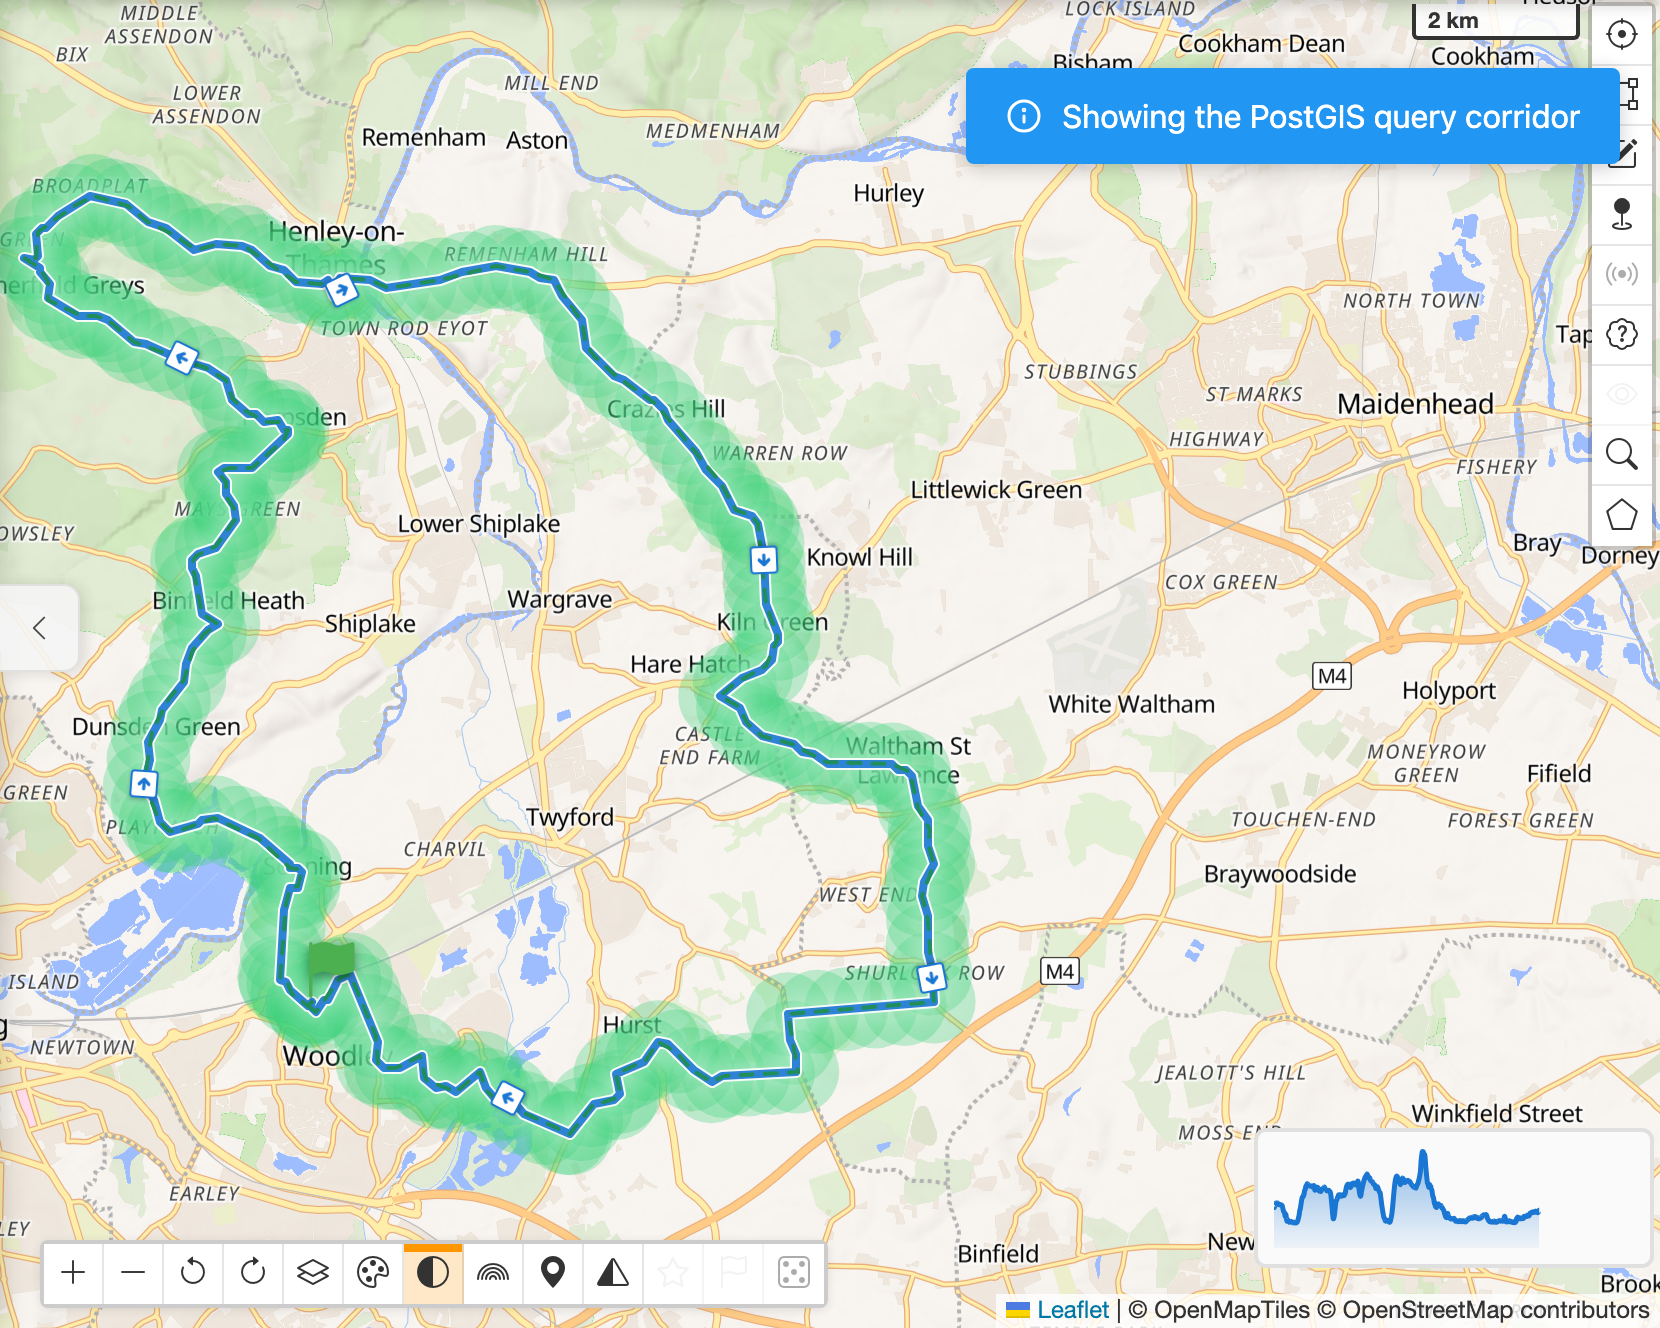
De hele rit van 44 km. Eén verzoek.
Voor het verzoek de browser verlaat
De meeste punten van de route worden eerst weggegooid. Een opgenomen GPX bevat er tienduizend; de corridor heeft er een paar honderd nodig. Douglas-Peucker met een tolerantie van 25 m doet het uitdunnen, en dat maakt het verzoek een grootteorde kleiner. De ruil is exact en het loont om hem te benoemen: de uitgedunde lijn blijft binnen 25 m van de opgenomen lijn, dus de rand van de corridor kan tot 25 m verschuiven. Een kraan op 490 m van de track die je reed, kan terugkomen op 515 m van de lijn die we stuurden. Bij een straal van 500 m merkt niemand dat; bij 100 m is het een kwart van de breedte, en bij die straal moet je het in je achterhoofd houden. De overlay tekent de uitgedunde lijn, zodat het beeld eerlijk blijft over wat er echt verstuurd is.
Een limiet van 10.000 punten en een straal van 35 km, afgedwongen op de server. Niemand vraagt meer. We vinden de grens gewoon liever zelf dan dat een fietser hem op een zondagochtend vindt.
De cache die dit allemaal verbergt
De snelste query is degene die niemand uitvoert. Dus een paar seconden nadat een route geladen is, terwijl je nog naar de kaart kijkt, vraagt PitStopper stilletjes alles op: alle 89 ingebouwde categorieën, langs elke geladen route, op een kilometer aan weerszijden. Lange routes gaan in stukken van 250 km, twee tegelijk, en het geheel wordt afgebroken zodra je zelf iets zoekt, zodat speculatief werk nooit voor een echte vraag in de rij staat. Het vraagt alleen ooit onze eigen server, nooit de publieke instantie waarop we terugvallen.
Wat terugkomt, wordt per categorie in de browser bewaard, in IndexedDB, met twee stukjes administratie die belangrijker zijn dan de plekken zelf: de straal waarmee het opgehaald is, en of het ophalen echt klaar is geraakt.
Die twee velden zijn de hele regel voor hergebruik. Een opgeslagen antwoord beantwoordt je zoekopdracht als het compleet is en als de straal waarmee het opgehaald is, minstens even groot is als de straal waar je naar vraagt. Cafés aanvinken bij de standaard 500 m is dus helemaal geen zoekopdracht: het is een opzoeking, en de app meet zelf de afstanden langs je route. Sleep de straalschuif voorbij een kilometer en het opgeslagen antwoord dekt de vraag niet meer, dus draait de corridorquery opnieuw, voor echt. Een mislukte ophaling wordt als onvolledig vastgelegd en nooit hergebruikt, want "hier is niets" en "we zijn het nooit te weten gekomen" zijn verschillende antwoorden.
Die cache op route indelen bleek het verkeerde instinct: een café verhuist niet als je een waypoint versleept, maar een sleutel die de vorm van de route volgt, verandert dan wel, en een corridor vol plekken raakt verweesd. De gegevens verhuizen daarom naar een vast raster van geografische cellen. Een cel hoort bij de wereld en niet bij je route, dus dezelfde cel antwoordt voor de route die je bewerkte, de route die je twee keer laadde, en de route van iemand anders over dezelfde weg.
Dat haalt wel wat glans van het verhaal hierboven. Het grootste deel van een sessie komt de database er niet aan te pas: je vinkt categorieën aan, sleept de straal onder een kilometer, en er verlaat niets de browser. De snelheid van de corridorquery zit verstopt achter een cache, en daar hoort ze ook, maar het betekent dat de cijfers in deze post niet zijn wat een fietser het grootste deel van de tijd voelt.
De afhankelijkheid loopt echter andersom. Elke categorie vooraf ophalen langs een route van 200 km is alleen betaalbaar dankzij de corridorquery: één verzoek per stuk, alle categorieën erin, het filteren gedaan in de database. Met de ketting van rechthoeken was diezelfde gulzigheid tientallen verzoeken per stuk geweest, en dat hadden we nooit aangedurfd. De cache is wat de snelle query ons opleverde.
Tellen zonder ophalen
Soms wil je weten wat er voor je ligt voor je iets ophaalt: 84 cafés, 2 waterkranen, helemaal geen tankstation. De app kan dat vooraf zeggen, en dan kun je beslissen wat het waard is om op te vragen.
Dat is dezelfde corridor, met dezelfde kandidaten, maar gevraagd om een aantal per categorie in plaats van een lijst plekken. Er komen helemaal geen punten terug, alleen getallen, en dat is precies de bedoeling: een limiet op hoeveel rijen er terug mogen komen, kan een telling niet stilletjes bederven als er geen rijen terugkomen. Categorieën zonder iets langs de route geven nul terug in plaats van te ontbreken, want "hier is niets" en "we hebben het niet nagekeken" zijn verschillende antwoorden, en de interface zegt welk van de twee het heeft.
Voor wie benieuwd is naar de SQL
Alles hierboven is het idee. Dit is de query, en de vier dingen die het waard zijn om erover te weten.
CREATE OR REPLACE FUNCTION pois_along_route(
    route_geojson TEXT, radius_m INTEGER, filters JSONB
) RETURNS TABLE (...) LANGUAGE sql STABLE PARALLEL SAFE AS $
    WITH corridor AS (
        SELECT ST_Subdivide(
            ST_Buffer(
                ST_SetSRID(ST_GeomFromGeoJSON(route_geojson), 4326)::geography,
                radius_m
            )::geometry,
            64) AS cell
    ),
    candidates AS (
        SELECT DISTINCT p.osm_type, p.osm_id, p.geom, p.tags, p.osm_timestamp
        FROM pois p
        JOIN corridor c ON p.geom && c.cell AND ST_Intersects(p.geom, c.cell)
    )
    SELECT osm_type, osm_id, ST_Y(geom), ST_X(geom), tags, osm_timestamp
    FROM candidates
    WHERE poi_matches_filters(tags, filters);
$;
4326 is gewone lat/lon. Elk coördinatenstelsel heeft een nummer, en 4326 is het stelsel dat de hele wereld gebruikt voor graden breedte en lengte: wat een GPS doorgeeft en wat in een GPX-bestand staat. ST_SetSRID vertelt PostGIS dat de binnenkomende getallen dat zijn, want GeoJSON bevat de coördinaten, maar niet het stelsel.
Buffer in meters, vergelijk in graden. De strook moet in meters getekend worden, want de straal is in meters en de import beslaat de hele planeet: een buffer in graden die voor Oxfordshire is ingesteld, komt in Tromsø van oost naar west amper half zo breed uit, zoals de twee stroken in de tekening hierboven tonen. Van noord naar zuid verandert er niets, want een graad breedte is overal even lang, dus de strook wordt platgedrukt en niet gewoon smaller. Maar de vergelijking moet geometrie tegen geometrie zijn, anders geldt de index niet. Dus teken je de strook in geography, zet je het resultaat terug om, en vergelijk je in geometry.
::geography is een cast (SQL voor het omzetten van een waarde van het ene type naar het andere), en het is dezelfde als in de eenvoudige query bovenaan, die het werk doet dat de tekening van Tromsø laat zien.
De strook in stukken hakken is het hele trucje. Een gebufferde corridor van 200 km is één enorme veelhoek met dezelfde nutteloze bounding box, dus ertegen testen is niet beter dan de naïeve versie. ST_Subdivide in cellen van hoogstens 64 hoekpunten geeft honderden kleine veelhoeken met krappe rechthoeken, en de index is voor elk ervan weer nuttig.
Twee tests per cel, en maar één ervan is duur. p.geom && c.cell is de rechthoekvraag die de index beantwoordt, en die gooit de planeet weg; ST_Intersects is de exacte test, en die draait alleen op wat de eerste overleefde. Dat paar is het hele mechanisme dat deze post beschrijft, uitgeschreven.
Haal de dubbels weg, want de stukken raken elkaar. Een café precies op de naad tussen twee stukken wordt twee keer gevonden. Eén DISTINCT: goedkoop om op te lossen, dom om zonder te leveren.
De telquery is hetzelfde met de laatste regel veranderd: dezelfde corridor, dezelfde kandidaten, count(*) per categorie in plaats van de rijen zelf.
SELECT cat.key,
       count(*) FILTER (WHERE poi_matches_filters(cand.tags, cat.value))
FROM jsonb_each(categories) AS cat(key, value)
LEFT JOIN candidates cand ON true
GROUP BY cat.key;
De planner zijn werk laten tonen
SQL zegt wat je wilt, nooit hoe je het krijgt, dus iets moet het hoe bepalen: dat is de planner. Bij een query bekijkt hij de mogelijke manieren om hem te beantwoorden, schat hij wat elke manier kost, en voert hij de goedkoopste uit. Een index gebruiken is een van die manieren, en de planner kiest die alleen als hij ziet hoe; anders leest hij de tabel van voor naar achter, en dat heet een sequential scan.
De omzetting naar ::geography breekt dat dubbel. De kolom geom is van het type geometry, dus als je hem omzet, kan de index erop helemaal niet gebruikt worden: de planner heeft niets om in te zoeken. En zelfs als het wel kon, zitten we terug bij de rechthoek, waar de rechthoek rond een lijn van 200 km toch een miljoen kandidaten oplevert.
Je kunt de planner zijn werk laten tonen, met EXPLAIN, en hij is er bot over. Hij zet een kost op elke manier van antwoorden: een schatting van hoeveel werk dat plan zou vragen. Lager is beter. Het getal is intern, geen seconden, dus één getal alleen zegt niets, maar twee naast elkaar zeggen veel.
Deze twee plannen komen van de publieke Postpass-instantie, die op verzoek het werk van haar planner toont, voor de eenvoudigere versie van deze query: een cirkel rond één punt, waar dezelfde omzetting dezelfde index op dezelfde manier onbruikbaar maakt.
| Hoe hij wil antwoorden | Geschatte kost (lager is beter) |
|---|---|
| De tabel van voor naar achter lezen en elke rij meten | 4.500.000.000 |
| Eerst de rechthoeken nakijken, dan wat overblijft meten | 4.600 |
Dezelfde vraag, dezelfde gegevens, hetzelfde antwoord op het einde. De planner verwacht dat het ene ongeveer een miljoen keer meer werk is dan het andere, en zo vertelt hij je dat hij je index heeft opgegeven.
Van de browser naar de database
Alles tot nu toe ging over de vorm van de query, tot in de SQL. Dit laatste stuk gaat over wie hem schrijft, en dat blijkt het grotere verschil te zijn tussen wat wij draaien en het ding waarop het geïnspireerd is.
De browser stuurt nooit SQL.
server.js, daarna gebonden parameters in een functie die al bestaat.Wat de browser verlaat, is een JSON-object met vier velden:
{
  "mode": "route",
  "route": [[[51.54, -0.90], [51.53, -0.92], ...]],
  "radius_m": 500,
  "filters": [[{"k": "amenity", "v": "cafe"}],
              [{"k": "amenity", "v": "drinking_water"}]]
}
route is de uitgedunde lijn uit "Voor het verzoek de browser verlaat". filters is de lijst categorieën: een of meer groepen per categorie, want een categorie kan op meerdere tagcombinaties passen. Er zit geen query in, alleen vier waarden.
nginx is de webserver die voor de onze staat. Hij handelt TLS af (de s in https) en doet het onopvallende werk: het verzoek moet komen van een pagina op pitstopper.net, onze telefoonapp of een lokale ontwikkelversie, drie verzoeken per seconde met pieken tot vijftien, een body van hoogstens 2 MB. Een script zonder Origin-header komt er nog steeds door, en daarvoor is de snelheidslimiet er. Daarna houdt hij een antwoordcache bij met de body van het verzoek als sleutel, wat alleen kan omdat de body een vaste vorm heeft. Twee fietsers die dezelfde categorieën langs dezelfde corridor vragen, delen één rit naar de database.
Die cache mag een antwoord 24 uur bewaren, wat lijkt te botsen met de updates van elk uur. Dat doet het niet, want elke update van het uur maakt hem als laatste stap leeg. De 24 uur is een plafond dat nooit bereikt wordt: een herhaalde zoekopdracht loopt hoogstens één update achter, en de herlaadknop per categorie stuurt ?nocache=1 om de cache helemaal over te slaan.
server.js controleert de vorm en de limieten, en eerlijk gezegd is dat alles wat het doet. Mode is route of point. Straal tussen 25 m en 35 km. Hoogstens 10.000 punten over hoogstens 32 routes; hoogstens 128 filtergroepen van hoogstens 8 tagparen; geen tag langer dan 256 tekens. Daarna zet het [lat, lon] om naar GeoJSON's [lon, lat] en doet het één aanroep:
pool.query('SELECT * FROM pois_along_route($1, $2, $3::jsonb)',
           [geojson, radius, filters]);
Dat zijn gebonden parameters, geen aan elkaar geplakte strings. De opdracht is een vaste tekst in het bestand en de waarden reizen ernaast, nooit erin geplakt, dus er is niets wat een slim benoemde tag naar binnen kan smokkelen: geen manier om de query vroeg af te breken en zelf een nieuwe te beginnen. Dat trucje heet SQL-injectie, en het maakt al sinds de jaren negentig databases leeg.
PostGIS doet dan alles waar de rest van deze post over gaat. De vijf functies in schema.sql zijn het hele vraagoppervlak: pois_along_route, pois_around_point, pois_count_by_category, ways_along_route en ways_around_point.
Omdat de tussenlaag niets bevat, zou het net zo goed PostgREST of pg_featureserv kunnen zijn, en noch de client noch de SQL zou het merken. Dat is geen netheid om de netheid. Het liet ons de hele backend op de stagingsite naast het oude Overpass-pad draaien, met dezelfde client en dezelfde categorieën achter een schakelaar, en cijfers krijgen in plaats van meningen.
En zo werkt Postpass bewust niet
Postpass neemt SQL aan. Je POST er een opdracht naartoe, het voert die uit, en je krijgt GeoJSON terug. Dat is de bedoeling ervan, en precies daarom was het de juiste basis voor een prototype: we konden een corridorquery uitproberen op een spiegel van de hele planeet zonder ook maar iets te installeren.
We gebruiken het nog altijd, en niet als museumstuk. De publieke instantie van Geofabrik is de laag waarop we terugvallen als onze beide eigen nodes het laten afweten, en sinds de Overpass-aanpak met al zijn losse verzoeken in augustus 2026 verwijderd is, staat er niets meer achter: Postpass is het laatste wat tussen een fietser en helemaal geen antwoord staat.
Beide vormen uit die tekening leven dus in dezelfde browser. Antwoordt onze server, dan stuurde de client parameters. Antwoordt hij niet, dan bouwt dezelfde client een SELECT en post die naar Geofabrik. Eén zoekopdracht, twee totaal verschillende ideeën over wie de query schrijft, gekozen tijdens het draaien, afhankelijk van of onze hardware in de lucht is.
De ruil verdient het om eerlijk benoemd te worden.
Wat we opgeven, is algemeenheid. Elke vraag waar we niet vooraf aan gedacht hebben, vraagt een nieuwe functie en een deploy, waar een gebruiker van Postpass gewoon een andere SELECT zou schrijven.
Wat we terugkrijgen, werkt alleen als de vorm vooraf bekend is. De planner ziet voor altijd dezelfde vijf opdrachten, dus een plan kan één keer nagekeken en daarna vertrouwd worden, in plaats van bij elk verzoek uitgedokterd te worden uit welke SQL er ook binnenkwam. De antwoordcache kan de body als sleutel gebruiken. En de limieten hierboven zijn af te dwingen, want "hoogstens 10.000 punten" is iets wat je over een veld kunt zeggen, niet over een query.
Wat het kost om te draaien
Gemeten op 12 september 2026 op een van onze twee nodes, srv01, die verzoeken beantwoordt als poi01, met een import van de hele planeet en onze lijst toegelaten tags. Niet geschat, en groter dan je zou verwachten van een post over interessante plekken, om een reden die het waard is om te zien.
| POI-rijen | 75,7 M |
| Way-rijen | 266 M |
| Database op schijf, met indexen | 219 GB |
| Flat-nodes-opslag van osm2pgsql | 106 GB |
| Gefilterde planet-PBF | 33 GB |
| Node-server, gebruikt geheugen | 49 MB |
De database is ongeveer zo verdeeld, telkens met de indexen van die tabel erbij: ways is 102 GB, de eigen tussentabel planet_osm_ways van osm2pgsql nog eens 91 GB, en pois (de tabel waar deze hele post over gaat) maar 24 GB. De POI-helft is de goedkope helft. De volledige geometrie van wegen is wat kost, en die hebben we bewust gekocht, voor de drie functies die een zwaartepunt niet kan bedienen.
Een way komt in beide tabellen terecht. pois bevat het zwaartepunt, en dat klopt voor een café in een gebouw, en ways bevat de volledige geometrie, het enige wat kan antwoorden op "waar verandert het wegdek" of "leg dit punt op een weg". Een zwaartepunt kan geen tunnel tekenen.
Updates draaien elk uur; een volledige herbouw vanaf de planeet draait elke maand. De herkomstrij bevat beide tijdstempels, want "hoe oud is de basis" en "hoe oud is de nieuwste wijziging" zijn verschillende vragen, en een waakhond voor verouderde gegevens heeft de eerste nodig.
Als je Postpass draait
Om duidelijk te zijn over wat we wel en niet overnamen: het idee komt van Postpass, de code niet. We draaien geen Postpass, en onze server is er geen fork van. Wat we kopieerden, is het recept dat iedereen kan kopiëren (osm2pgsql naar PostGIS, HTTP ervoor) en daarna schreven we een paar honderd regels om de vijf vragen te beantwoorden die we echt stellen. Heb je het algemene ding nodig, draai dan Postpass. Het is goed, en je eigen schrijven is alleen de moeite waard als je eisen smaller zijn dan die van het project, en dat geldt voor minder mensen dan je zou denken.
Wat je ook draait, zet de flat-nodes-opslag van osm2pgsql op je snelste schijf. Het is een platte array met het OSM-node-id als index, 106 GB groot, en zo hoeft de import de posities van alle nodes op de planeet niet in het RAM te houden. We hebben de onze ooit per ongeluk naar een USB-NVMe verhuisd, en de updates van elk uur gingen van 33 seconden naar 17 minuten.
Wil je routecorridors op je eigen instantie, neem dan ST_Subdivide op een geography-buffer en laat de rest liggen. Die ene aanroep is het verschil tussen een query die er correct uitziet en een query die draait. Al de rest hier is onze eigen smaak in tagfilters.
Nog één ding is een uur van je tijd waard als je van Overpass overstapt in plaats van opnieuw te beginnen: onze antwoordvorm is bewust compatibel met Overpass, {elements: [...]} met ruwe tags, nodes met lat/lon en ways met een middelpunt. De client die met Overpass praatte, had een adapter en ongeveer een namiddag nodig.
Zelf de corridor zien
Alles wat hierboven afgebeeld staat, is Systeem → Zoekgebied Tonen in PitStopper, op elke geladen route. Het tekent cirkels die in meters kloppen langs de uitgedunde lijn, met de actuele straal, dus als je de straalschuif versleept, wordt het echte zoekgebied opnieuw getekend. We bouwden het om dit werk te debuggen en lieten het erin, want een ruimtelijke query die je niet kunt zien, is een ruimtelijke query waarnaar je gist.