Aus dem Englischen übersetzt.
Wenn du PitStopper bittest, dir die Cafés, Wasserhähne, Läden oder Unterstände entlang einer Route zu zeigen, muss es eine Frage beantworten, die einfach klingt und es nicht ist:
Welche Orte liegen höchstens 500 Meter von dieser 200 km langen Linie entfernt?
Nicht in der Nähe eines Punkts. Nicht in einem Rechteck. Entlang einer krummen Linie, 200 km lang, und die Antwort soll da sein, bevor dir langweilig wird.
Auf diese Frage gibt es eine gute Antwort und mehrere plausible schlechte. Eine der schlechten haben wir acht Monate lang betrieben, und der naheliegende Weg, sie zu verbessern, entpuppt sich als die nächste. In diesem Beitrag geht es darum, wie die gute funktioniert: was PostGIS ist, warum die naheliegende Abfrage langsam ist, und welcher kleine Trick die endgültige Version schnell macht.
Erst mal: Was ist PostGIS?
Drei Schichten, und nur die mittlere ist ungewohnt.
PostgreSQL ist eine ganz normale Datenbank, so eine, wie sie hinter den meisten Websites steckt. Sie speichert Datenzeilen und lässt dich darin suchen und filtern.
PostGIS ist eine Erweiterung für PostgreSQL, die ihr Formen beibringt. Eine Spalte kann einen Punkt, eine Linie oder eine Fläche enthalten, so wie eine andere Spalte einen Namen oder einen Preis enthält, und ein paar hundert neue Funktionen lassen dich Fragen dazu stellen: Was liegt in der Nähe von was, was kreuzt was, wie weit sind zwei Dinge voneinander entfernt.
PitStopper nutzt beides zusammen, um eine durchsuchbare Kopie von OpenStreetMap vorzuhalten, und fragt sie, wo Dinge im Verhältnis zu deiner Route liegen.
Ganz konkret ist ein Café in unserer Datenbank eine Zeile, die ungefähr so aussieht:
name      The Coffee House
location  POINT(-0.9016 51.5372)
tags      amenity=cafe
Und eine Route, die du geladen hast, ist ebenfalls eine Form:
geometry LINESTRING(-0.89 51.53, -0.91 51.54, ...)
Deine Route wird nicht bei den Cafés gespeichert: Sie kommt mit der Frage an und ist danach wieder weg. Aber sobald beide in derselben Sprache ausgedrückt sind, lässt sich eine Frage stellen: Welche dieser Punkte liegen höchstens 500 Meter von dieser Linie entfernt? Das ist die ganze Idee, und alles Weitere handelt davon, das schnell zu machen.
Woher die Daten kommen
OpenStreetMap ist eine freie Weltkarte, die jeder bearbeiten kann, das Wikipedia der Karten. Über zwei Millionen Menschen haben die Straßen, Wege, Cafés, Bänke und Wasserhähne in ihrer Umgebung eingetragen. Alles darin wird mit einfachen Schlüssel-Wert-Etiketten beschrieben, den sogenannten Tags: Ein Café ist amenity=cafe und ein Trinkbrunnen amenity=drinking_water, und genau darauf passen unsere Suchen.
Wichtig ist hier, dass man die ganze Datenbank herunterladen kann. Wir fragen nicht höflich bei einem fremden Kartendienst an; wir haben unsere eigene Kopie und fragen sie, was wir wollen.
Der Haken: Eine Kopie veraltet, und OSM steht nie still: Millionen Bearbeitungen pro Tag, jeden Tag. Deshalb laufen unsere Updates stündlich und nicht dann, wenn es uns gerade einfällt.
Warum nicht einfach OpenStreetMap fragen?
Berechtigte Frage, und lange Zeit haben wir genau das gemacht.
OpenStreetMap sind die Daten. Sie abzufragen ist ein eigenes Problem, und Overpass ist die übliche Antwort darauf. Damit hat PitStopper angefangen, und die meiste Zeit auf eigener Hardware: Wir haben acht Monate lang unsere eigene, aktuell gehaltene Overpass-Instanz betrieben.
Das hat funktioniert. Es war nur langsam, und je länger die Route, desto langsamer, wegen der Form der Frage und nicht wegen der Hardware. Overpass beantwortet „Was liegt in diesem Rechteck?“ gut. Man kann es auch nach einer Linie fragen - around: nimmt eine ganze Polylinie, nicht nur einen Punkt -, aber bei einer Route mit Tausenden Punkten ist diese Abfrage so teuer, dass sie praktisch nicht taugt, und es war für uns billiger, stattdessen viele Rechtecke zu schicken. Das haben wir also getan: je eine Anfrage pro Rechteck, und das Ganze noch mal für jede Kategorie.
Die Daten selbst zu halten war nie das Problem. Was sich geändert hat, ist, was wir sie fragen konnten. Leg dieselben OpenStreetMap-Daten in PostGIS, und die Abfrage lässt sich nach dem formen, was PitStopper wirklich braucht, statt sie aus der einen Frage zusammenzubauen, die die API beantworten kann.
Postpass war die Zwischenstation, die uns gezeigt hat, dass sich das lohnt. Es legt OpenStreetMap in PostGIS und bietet SQL über HTTP an: Du schickst eine Abfrage statt Parametern und bekommst GeoJSON zurück, ein einfaches Textformat zur Beschreibung von Formen. Kein radius=, keine feste Liste von Endpunkten, einfach SQL gegen einen Spiegel des ganzen Planeten. Diese Offenheit macht eine ganze Klasse von Fragen, mit denen Overpass Mühe hat, völlig alltäglich.
Drei Namen tauchen ab hier immer wieder auf, und sie unterscheiden sich nur durch einen Buchstaben und eine Idee:
- Overpass: der altbewährte Weg, OpenStreetMap Fragen zu stellen. Gut bei „Was liegt in diesem Rechteck?“. Das, was wir in unseren ersten acht Monaten betrieben haben.
- Postpass: dieselben Daten in PostGIS, beantwortet SQL, das per HTTP geschickt wird. Daher stammt die Korridor-Abfrage, und es ist immer noch das Letzte, was übrig bleibt, wenn unsere beiden Rechner ausfallen.
- Unser eigener Server: dasselbe Rezept, aber das SQL ist in die Datenbank gewandert, sodass der Browser stattdessen Zahlen schickt. Der antwortet heute.
Alles beginnt mit einem Rechteck
Eine räumliche Datenbank ist aus einem einzigen Grund schnell. Sie vergleicht deine Abfrage nicht mit jeder Zeile. Sie merkt sich für jedes Objekt eine Bounding Box, ein einfaches Rechteck drumherum, und der räumliche Index lässt sie in einem einzigen Schritt alles verwerfen, dessen Rechteck deins nicht berührt. Nur die Überlebenden müssen durch den genauen, teuren Geometrietest.
Dieser Index hat einen Namen, dem du in jeder PostGIS-Diskussion begegnest: GiST. Das ist der Index, den PostGIS auf einer Geometriespalte anlegt, und er macht aus „Welche Rechtecke überlappen dieses Rechteck?“ einen einzigen Nachschlag statt 75 Millionen Vergleichen. Wenn in diesem Beitrag „der Index“ steht, ist der gemeint.
Ganz grob darf der Index sagen: Dieses Café liegt offensichtlich nirgends in der Nähe des Gebiets, das uns interessiert, also ignorier es.
Die Größe deines Rechtecks entscheidet also alles.
Frag „Was liegt im Umkreis von 500 m um dieses Café?“, und dein Rechteck ist ein Quadrat von einem Kilometer Seitenlänge. Der Index wirft den Planeten weg und gibt vierzig Kandidaten zurück. Frag „Was liegt im Umkreis von 500 m um diese 200-km-Route?“, und dein Rechteck ist das kleinste, in das die ganze Route passt, also ein, zwei Landkreise. Der Index verwirft immer noch, aber ein Rechteck dieser Größe lässt rund eine Million Kandidaten übrig, und jeder davon muss einzeln durch den genauen Test.
Diese eine Tatsache erklärt sowohl den Ansatz, den wir ausgeliefert haben, als auch die Abfrage, die man ganz natürlich als Ersatz schreiben würde.
Was wir zuerst ausgeliefert haben: Rechtecke über Rechtecke
Deck die Route mit einer Kette von Bounding Boxes ab und frag jede einzeln ab. Genau das waren diese acht Monate. Es funktioniert, und es verschwendet eine Menge, weil ein Rechteck um ein schräges Straßenstück hauptsächlich aus Feldern besteht und eine kurvige Route viele Rechtecke braucht. Dazu reagiert Overpass schlecht auf eine einzelne Abfrage mit mehr als einer Handvoll unabhängiger Tag-Filter, also haben wir nie mehr als sechs Kategorien auf einmal geschickt: Rechtecke mal Kategorien, und aus einer langen Tour wurden Dutzende Anfragen, von denen einige ins Timeout liefen.
Es lohnt sich, klar zu sagen, wo die Zeit hinging, denn am Server lag es nicht. Die Instanz gehörte uns, sie war aktuell, und sie musste mit niemandem um Kapazität kämpfen. Die Kosten steckten in der Form der Frage: Dutzende Hin-und-Her-Anfragen pro Suche, und jede lieferte Dinge, an denen du nie vorbeikommen würdest.
Der Korridor ist die Form, die du eigentlich meinst
Eigentlich wollen wir kein Rechteck durchsuchen. Hundert kleine Rechtecke wollen wir aber auch nicht durchsuchen.
Was wir wirklich meinen, ist: Gib mir alles innerhalb dieses Bands, das der Route folgt.
Das ist ein Korridor. Wenn die Route 200 km lang ist und der Suchradius 500 Meter beträgt, ist der Korridor einfach die Route mit 500 Metern auf jeder Seite. PostGIS zeichnet uns diese Form mit einer Funktion namens ST_Buffer.
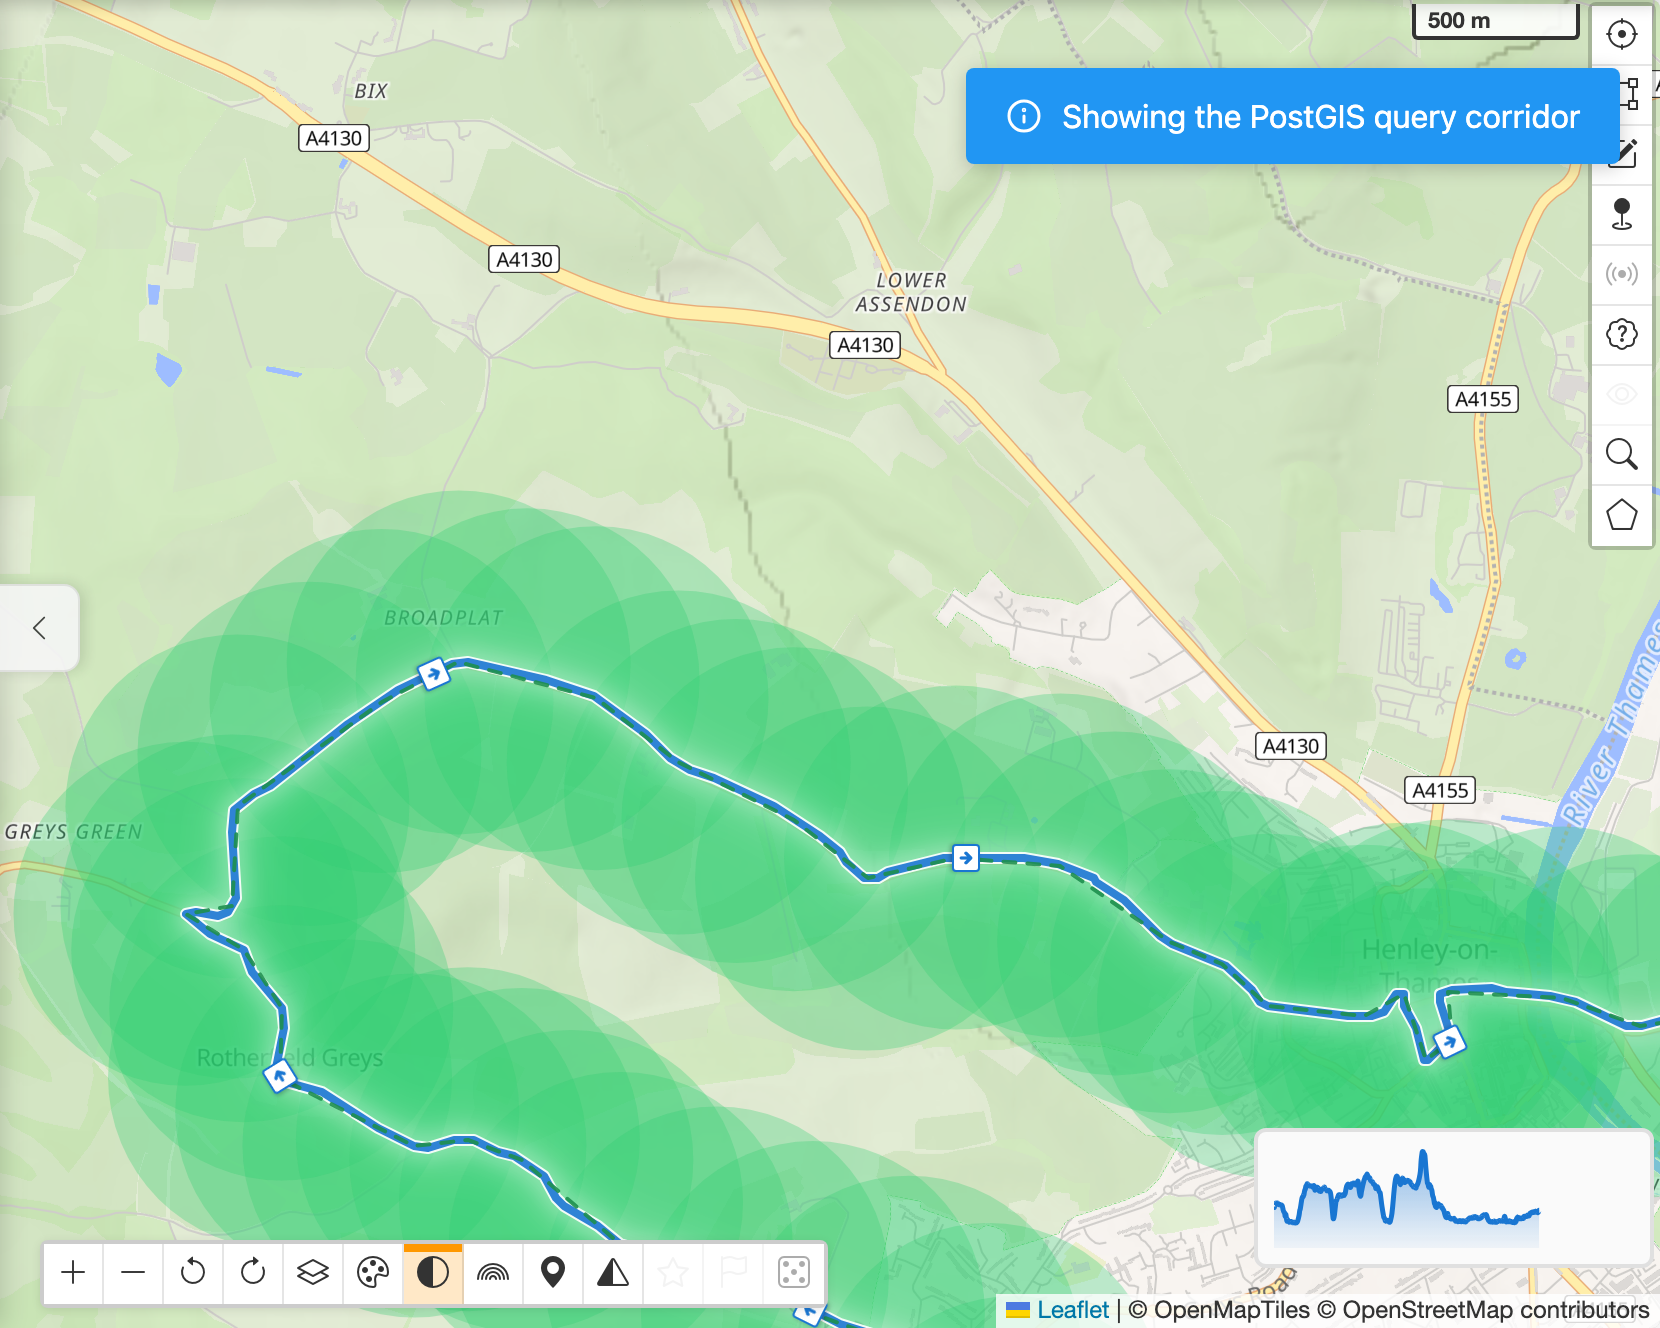
Wichtig ist: Das ist keine Annäherung an die Route. Es ist genau das Suchgebiet, das wir meinen. Hier ist einer, von der App gezeichnet, mit dem Radius, den die Abfrage tatsächlich verwendet:
Und dieselbe Ansicht nach der Suche, mit den Punkten, die dieser Korridor zurückgegeben hat:
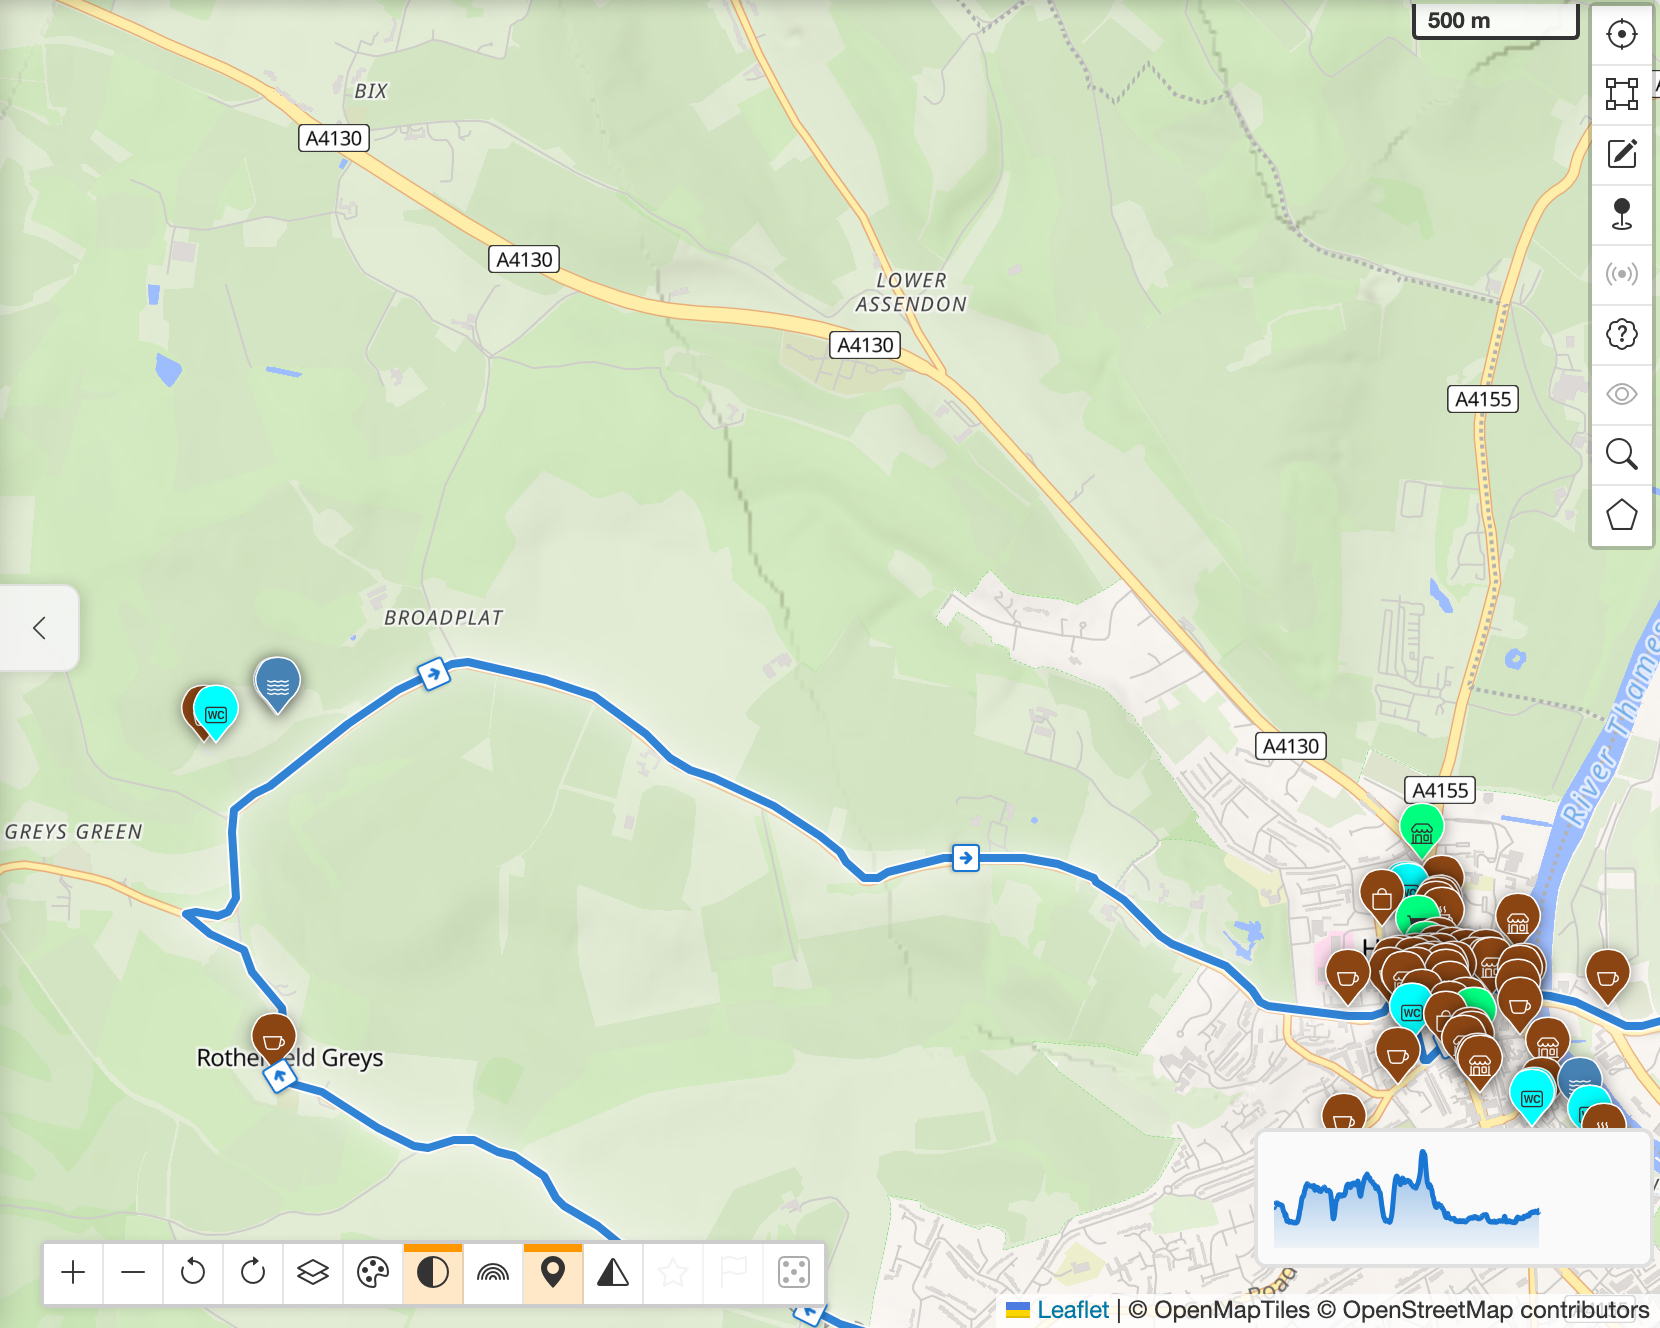
Die Gruppe in Henley ist das, was man erwartet. Spannend ist das Paar draußen bei Broadplat: ein paar hundert Meter abseits der Straße, nichts drumherum, genau das, was ein schlampiger „nah an der Route“-Test wegwirft. Es ist außerdem das einzige Wasser auf acht Kilometern.
Die Abfrage, die du zuerst schreibst
Wechsel zu PostGIS, und der Korridor ist keine Form mehr, die du mit Rechtecken annähern musst. Du kannst einfach danach fragen:
SELECT * FROM pois
WHERE ST_DWithin(geom::geography, route::geography, 500);
Auf Deutsch: Gib mir jeden Ort, der höchstens 500 Meter von dieser Route entfernt ist.
Falls SQL nicht deine Sprache ist, das sind die Teile:
poisist unsere Tabelle der Orte, eine Zeile pro Café, Wasserhahn, Bank oder Unterstand. 75 Millionen davon.geomist, wo ein Ort liegt, undrouteist die Linie, die du geladen hast.ST_DWithinist die Frage: Liegen diese beiden Formen höchstens 500 voneinander entfernt? Fast jede PostGIS-Funktion heißtST_irgendwas, für „spatial type“ (räumlicher Typ).::geographysorgt dafür, dass500500 Meter bedeutet und nicht 500 Grad. Das ist wichtiger, als es aussieht, und am Ende gibt es einen Abschnitt für alle, die die Geschichte dazu hören wollen.
Korrekt, gut lesbar, und ein Full Table Scan im Kostüm eines räumlichen Index. „Jeder Ort, den wir haben“ sind 75 Millionen Abstandsberechnungen gegen eine 200 km lange Linie.
Zwei Dinge stimmen daran nicht, und um das zweite geht es in diesem Beitrag. Das unmittelbare Problem ist das ::geography: Wenn eine Spalte unterwegs umgewandelt wird, kann der Index auf dieser Spalte gar nicht abgefragt werden, also kommt die Abfrage nie bis zur Rechteck-Stufe. Behebst du das, triffst du auf das Rechteck - das Rechteck um eine 200 km lange Linie übergibt immer noch den Großteil der Datenbank an den genauen Test, der sich da durchkämpfen muss. Die Umwandlung ist ein Fehler, den du in einer Minute korrigierst; das Rechteck ist die Form des Problems. Der Abschnitt über den Planer weiter unten liefert die Belege für beides.
Die Lösung: das Band in Kacheln schneiden
Ein 200-km-Korridor ist selbst eine riesige Form, und das Rechteck darum ist derselbe Landkreis oder zwei wie vorher. Also schneiden wir ihn mit ST_Subdivide in kurze Abschnitte.
Stell es dir so vor, als würdest du der Datenbank eine Karte aus kleinen Kacheln geben statt eines riesigen Bogens. Jede Kachel ist klein, also ist das Rechteck darum klein, also ist der Index wieder nützlich: Für jede Kachel kann er fast die ganze Datenbank in einem Schritt wegwerfen. Dieselbe Antwort, gefunden mit einem Bruchteil der Arbeit.
Der Unterschied, den man festhalten sollte: Wir zerteilen den Korridor der Datenbank zuliebe, nicht weil wir die Route annähern. Das Band bleibt das Band.
Haben wir das nicht schon mit Bounding Boxes gemacht?
Schnell gesagt klingen die beiden Ansätze wie zweimal dieselbe Idee: Route zerschneiden, nach jedem Stück fragen. Der Unterschied liegt darin, was die Stücke sind und wer sie je zu sehen bekommt.
| Rechtecke, über Overpass | Korridorzellen, innerhalb von PostGIS |
|---|---|
| Rechtecke werden über die Route geworfen | Der Korridor folgt der Route bereits |
| Das Rechteck ist die Frage | Die Zelle ist die Art, wie der Index gefragt wird |
| Übers Netz geschickt, je eine Anfrage | Verlassen nie die Datenbank |
| Was im Rechteck liegt, kommt zurück | Kandidaten werden zuerst gegen das echte Band getestet |
| Ein Café drei Felder weiter ist ein Treffer | Ein Café drei Felder weiter fliegt raus, bevor die Antwort rausgeht |
| Dutzende Anfragen, manche mit Timeout | Eine Anfrage, alle Kategorien auf einmal |
Die Overpass-Rechtecke waren die Frage: Ein Rechteck ging übers Netz raus, und alles, was darin lag, kam zurück, auch das Café drei Kilometer von der Straße. Die Korridorzellen sind Leitungen, die nie jemand sieht: Jede bringt eine Handvoll Kandidaten hervor, und jeder Kandidat wird dann gegen das Band selbst getestet, bevor die Antwort die Datenbank verlässt. Das Zerschneiden ist geblieben; was zerschnitten wird und was zurückkommt, hat sich beides geändert.
Was beim Suchen wirklich passiert
your route
    |  thinned to a few hundred points
    v
sent as a list of points
    |  turned into GeoJSON on the server
    v
a line the database understands
    |  ST_Buffer, 500 m
    v
a corridor
    |  ST_Subdivide
    v
short sections
    |  spatial index, one step per section
    v
candidate places
    |  tested against the real corridor, then the tag filters
    v
results
Die meisten Suchen kommen nie über die erste Zeile davon hinaus, weil die Antwort schon im Browser liegt. Warum, steht weiter unten unter „Der Cache, der das alles versteckt“.
Was das für dich auf dem Rad bedeutet
Denk an die beiden Wasserhähne bei Broadplat zurück: ein paar hundert Meter abseits der Straße, das einzige Wasser auf acht Kilometern, und genau das, was ein Rechteck in Routennähe erwischt oder verpasst, je nachdem, wo das Rechteck zufällig endet. Die echte Frage zu stellen - alles innerhalb eines Bands von 500 Metern auf jeder Seite der Linie, die ich fahre - bringt sie zurück. Dafür ist das alles da. Der Rest ist, was es möglich macht:
- Lange Routen bedeuten keine Dutzende einzelner Suchen mehr.
- Alle Kategorien werden zusammen durchsucht statt einzeln.
- Das Suchgebiet folgt der Route, statt eine Sammlung großer Rechtecke in ihrer Nähe zu sein.
- Gefiltert wird in der Datenbank, also geht die Antwort übers Netz und nicht das Rohmaterial.
- Derselbe Ansatz funktioniert für eine 20-km-Feierabendrunde und eine 700-km-Tour.
Frag nach allem im Umkreis von 500 Metern um eine 700-km-Route, und das ist eine Frage, einmal gestellt.
Die Zahlen. Zwei Läufe am selben Tag, dem 11. Juli 2026, mit dem Testaufbau aus dem Repository (tests/e2e/poi-backend-compare.diag.spec.js) gegen die Staging-Umgebung. Es ist wichtig, welcher welcher ist.
Der erste ist der, der den Umstieg gerechtfertigt hat. Er hat den alten Overpass-Weg gegen eine PostGIS-Korridorabfrage antreten lassen, beide Seiten ohne Cache:
| die Suche | Overpass | PostGIS-Korridor |
|---|---|---|
| 6 km, 8 Kategorien | 4,3 s | 0,19 s |
| 180 km, 8 Kategorien | 9,7 s | 0,66 s |
| 180 km, 20 Kategorien bei 1 km | 20,1 s | 0,85 s |
| 700 km, 8 Kategorien | nie fertig, 120-s-Timeout | 2,8 s |
| 700 km, 20 Kategorien bei 1 km | nie fertig, 120-s-Timeout | 4,1 s |
Fünfzehn- bis vierundzwanzigmal schneller bei den Suchen, die fertig wurden, und zwei, die keine Fehlschläge mehr waren. Die PostGIS-Spalte ist dort das öffentliche Postpass von Geofabrik, weil wir zu dem Zeitpunkt noch nichts Eigenes gebaut hatten. (Die vollständige Tabelle im Repository hat elf Zeilen und eine größere Spanne, von 3x bei einer dichten 5-km-Punktsuche bis 34x bei einer kurzen Route mit zwanzig Kategorien.)
Am selben Abend, als unser eigener Server existierte, hat ein zweiter Lauf alle drei nebeneinandergestellt. Unser Knoten hat die öffentliche Instanz in jeder Zeile geschlagen, und das ist das Argument für einen eigenen Server: dieselbe Idee, aber die Fragen stehen vorher fest, und die Daten sind auf das gefiltert, was wir tatsächlich fragen.
| die Suche | öffentliches Postpass | unser eigener Server |
|---|---|---|
| 6 km, 1 Kategorie | 157 ms | 79 ms |
| 180 km, 1 Kategorie | 909 ms | 182 ms |
| 180 km, 8 Kategorien | 685 ms | 241 ms |
| 180 km, 20 Kategorien bei 1 km | 933 ms | 312 ms |
| Parkplätze im Umkreis von 170 m, Reading | 8-s-Timeout | 206 ms |
Zwei Zeilen brauchen eher eine Einschränkung als Angeberei.
Eine Kategorie auf der 180-km-Route kam langsamer zurück als acht auf derselben Route, was für die geleistete Arbeit nicht stimmen kann. Die öffentliche Instanz ist ein kostenloser, geteilter Dienst ohne Antwort-Cache, also schwanken ihre Zahlen mit dem, was alle anderen sie gerade fragen. Lies diese Spalte als Größenordnung und nicht genauer. Das Rauschen gehört zum Argument für einen eigenen Server; es ist kein Beweis, dass wir viermal besser darin sind.
Die Parkplatz-Zeile ist auch kein Postpass-Fehler, und sie ist die nützlichste Zeile der Tabelle. amenity=parking ist eine der größten Tag-Mengen in OpenStreetMap: Wir haben 6.779.228 davon, und sie einfach nur zu zählen, ganz ohne Geografie, dauert auf unserem eigenen Knoten etwa drei Sekunden. Die Antwort auf „Parkplätze im Umkreis von 170 Metern um diesen Punkt in Reading“ ist zwei, in 206 ms. Alles hängt davon ab, die anderen 6.779.226 per Rechteck zu verwerfen, bevor irgendetwas einen Tag anschaut, und darum geht es in diesem ganzen Beitrag, und genau das verhindert die ::geography-Umwandlung still und leise.
Zwei Läufe an einem Tag, also lies alles als Größenordnungen und nicht als Benchmarks. Entscheidend ist die Form: Die Suche explodiert nicht mehr mit der Länge der Route.
Das Band ist echte Meter breit
Weil das Band in Metern statt in Grad gezeichnet wird, stimmt seine Breite auf jedem Breitengrad, und die Debug-Ansicht zeichnet es genauso. Was du auf der Karte siehst, ist die Abfrage.
geography sorgt dafür, dass 500 überall 500 Meter bedeutet.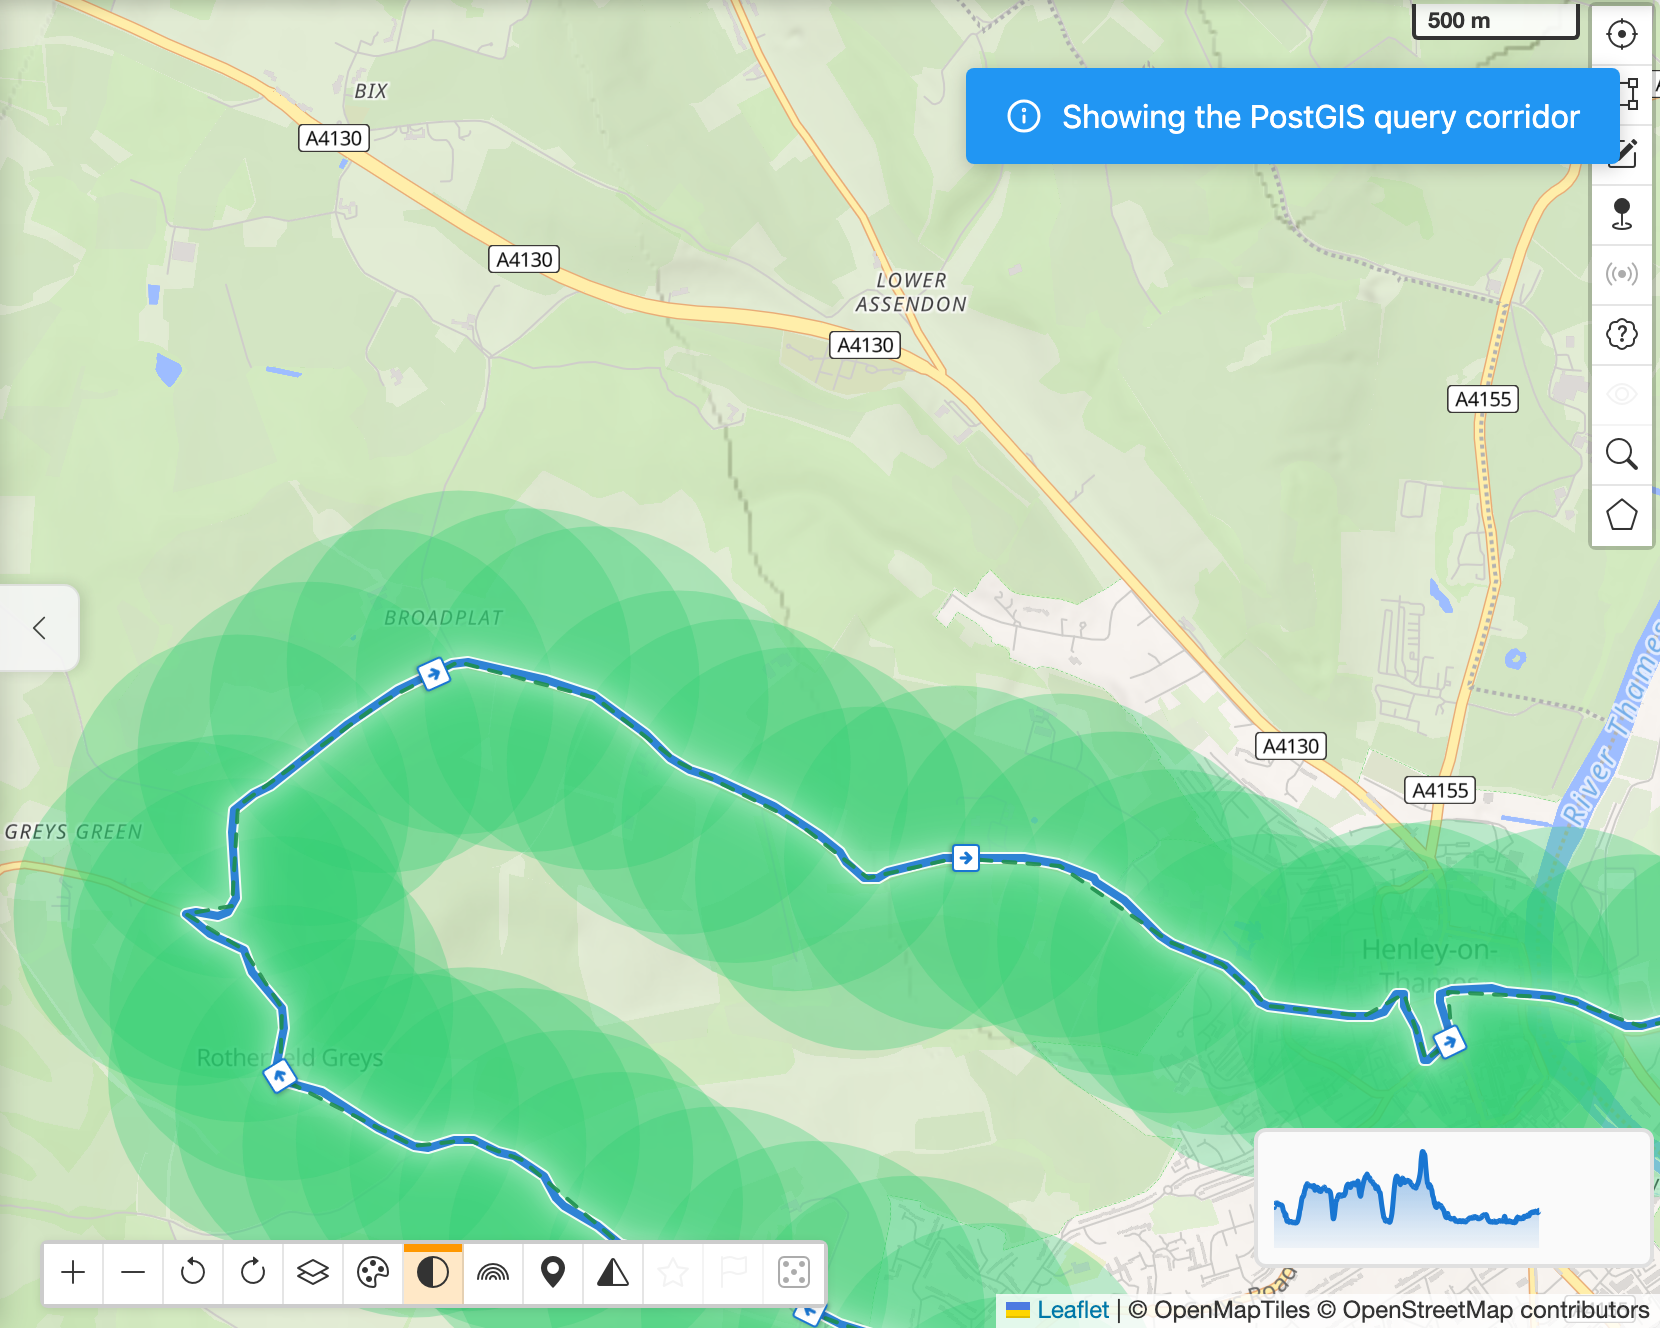
Das ist dieselbe Ansicht bei 100 m statt 500 m. An der Abfrage ändert sich nichts außer der Zahl.
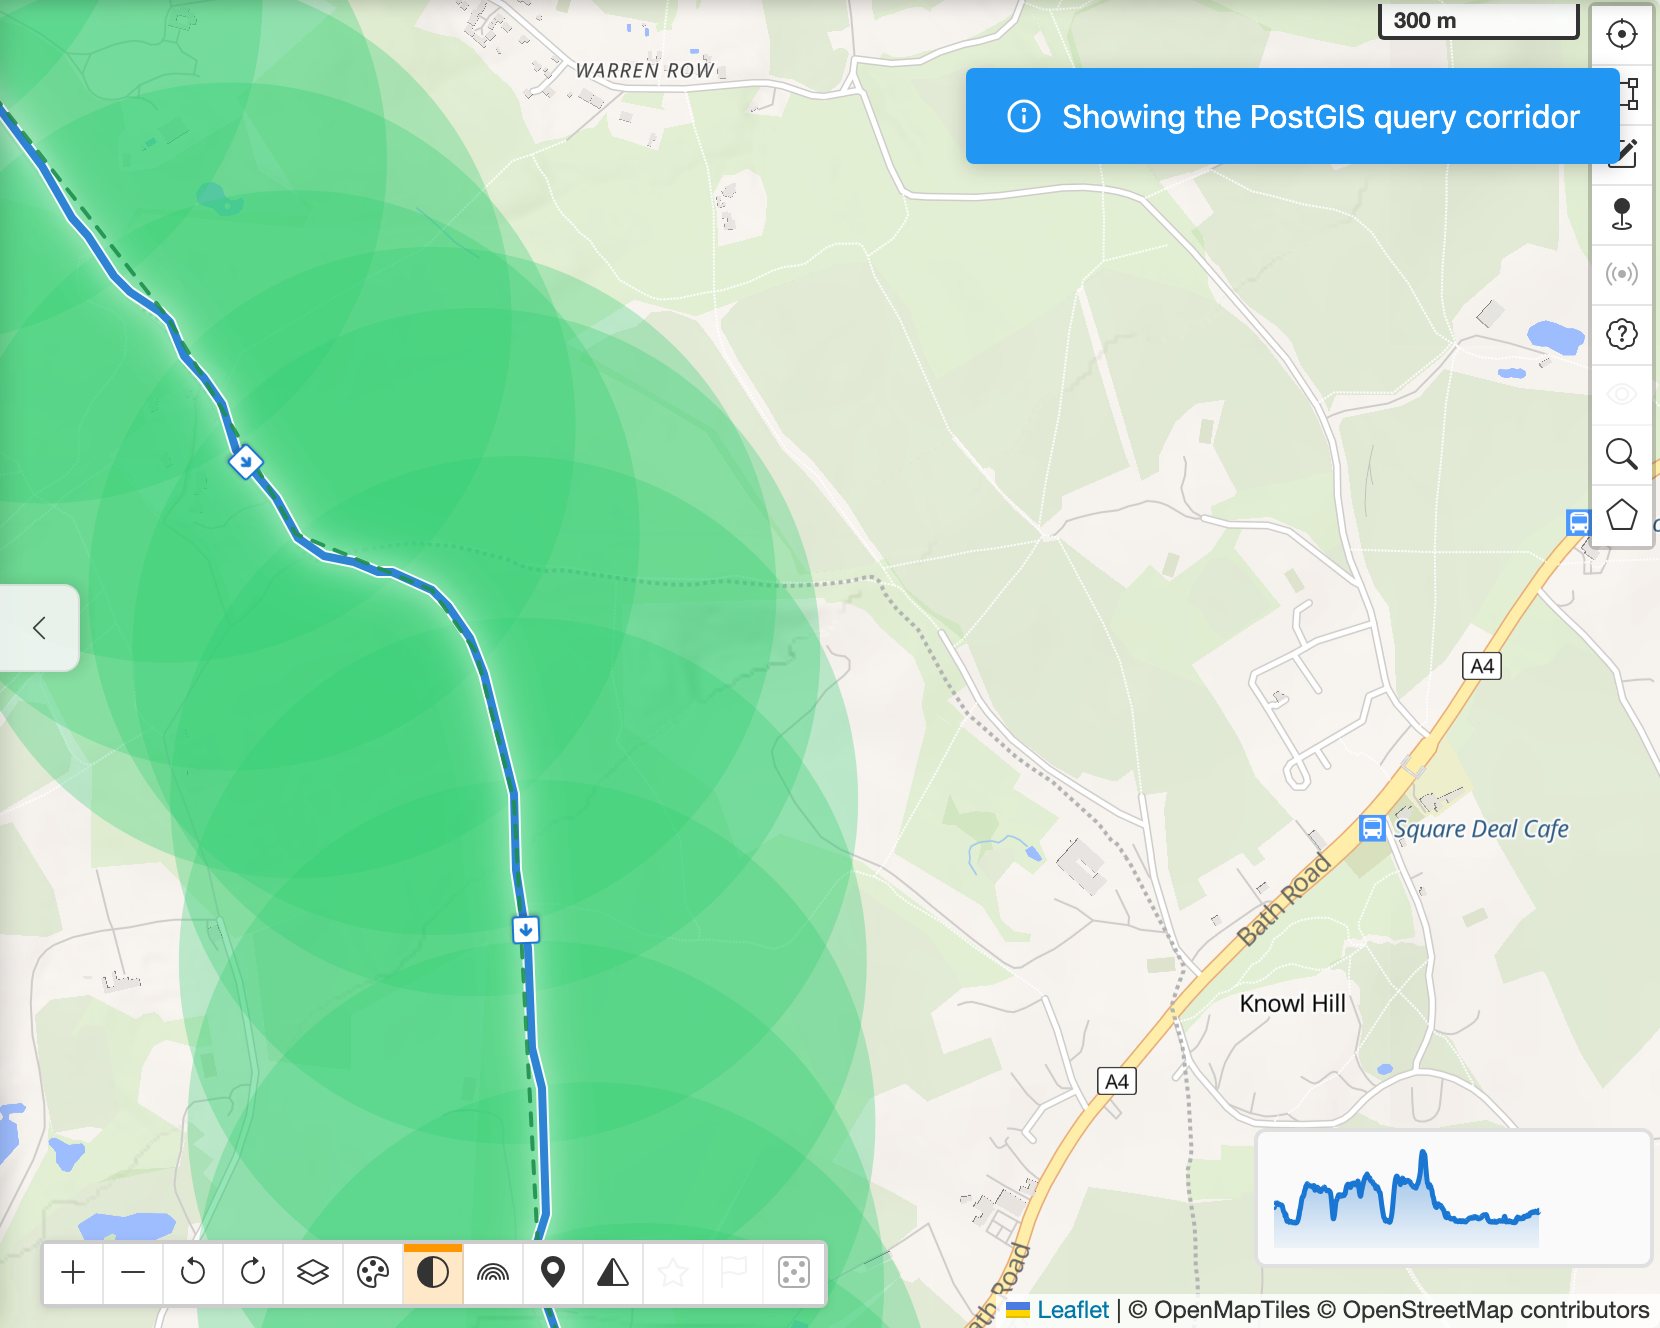
Dieselbe Ansicht in einer Kurve. Der Rand des Bands hält rund um die Kurve denselben Abstand zur Straße, und genau das bedeutet „höchstens 500 Meter von der Route entfernt“. Alles östlich davon gehört hier einfach nicht zur Frage: die Felder, Knowl Hill, die A4, die dort durchführt.
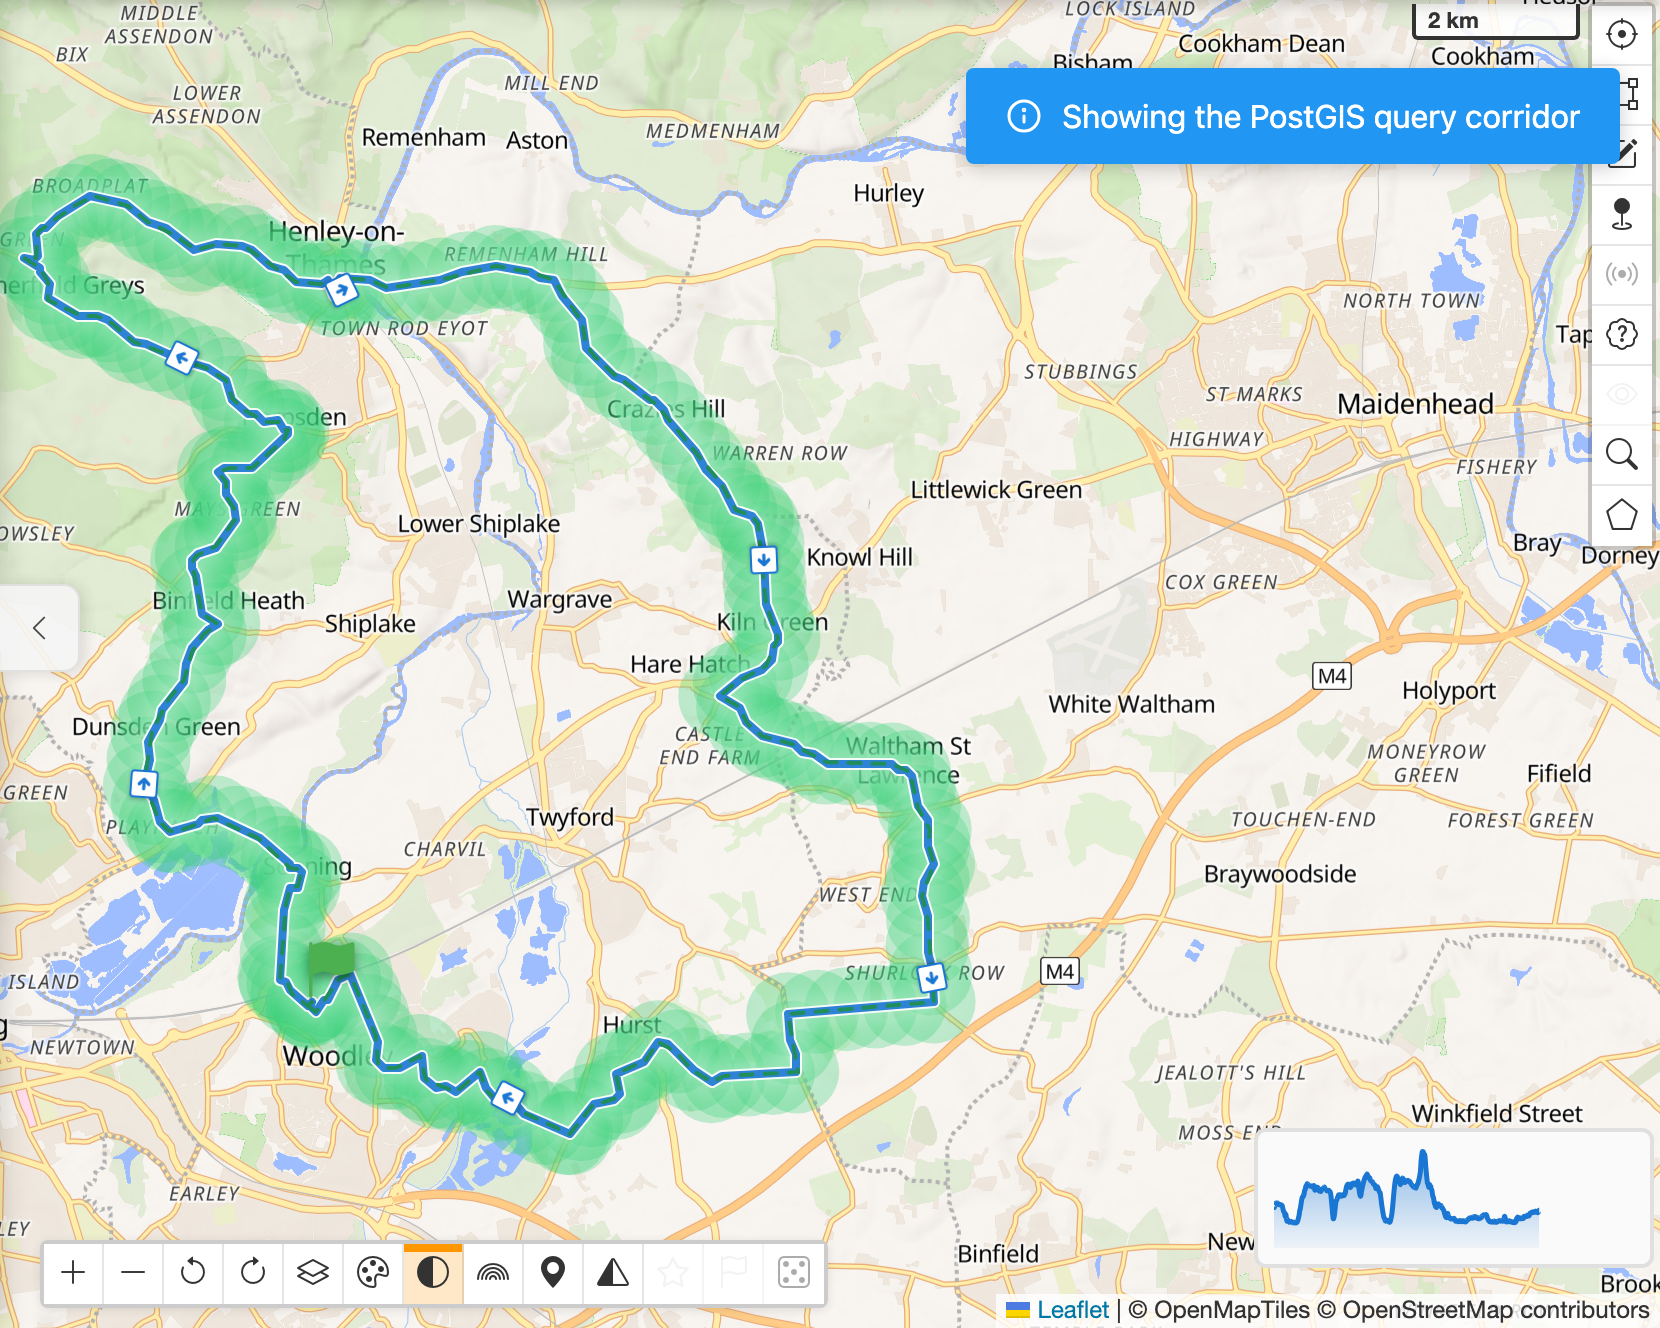
Die ganze 44-km-Runde. Eine Anfrage.
Bevor die Anfrage den Browser verlässt
Die meisten Punkte der Route werden zuerst weggeworfen. Ein aufgezeichnetes GPX enthält zehntausend davon; der Korridor braucht ein paar hundert. Douglas-Peucker mit 25 m Toleranz übernimmt das Ausdünnen und macht den Anfrage-Body um eine Größenordnung kleiner. Der Preis dafür ist genau bekannt und sollte gesagt werden: Die ausgedünnte Linie bleibt höchstens 25 m von der aufgezeichneten entfernt, also kann sich der Rand des Korridors um bis zu 25 m verschieben. Ein Wasserhahn 490 m von deinem gefahrenen Track kann 515 m von der Linie entfernt landen, die wir geschickt haben. Bei 500 m Radius merkt das niemand; bei 100 m ist es ein Viertel der Breite, und bei diesem Radius solltest du es im Hinterkopf behalten. Die Ansicht zeichnet die ausgedünnte Linie, das Bild bleibt also ehrlich darüber, was tatsächlich geschickt wurde.
Eine Obergrenze von 10.000 Punkten und 35 km Radius, auf dem Server durchgesetzt. Niemand fragt nach mehr. Wir finden die Grenze nur lieber selbst, als dass jemand sie an einem Sonntagmorgen findet.
Der Cache, der das alles versteckt
Die schnellste Abfrage ist die, die niemand ausführt. Deshalb fragt PitStopper ein paar Sekunden nachdem eine Route fertig geladen ist, während du noch auf die Karte schaust, still und leise nach allem: alle 89 eingebauten Kategorien, entlang jeder geladenen Route, einen Kilometer auf jeder Seite. Lange Routen gehen in 250-km-Abschnitten raus, zwei auf einmal, und das Ganze wird abgebrochen, sobald du selbst nach etwas suchst, damit spekulative Arbeit nie vor einer echten Frage in der Schlange steht. Es fragt immer nur unseren eigenen Server, nie die öffentliche Instanz, auf die wir zurückfallen.
Was zurückkommt, wird pro Kategorie im Browser gespeichert, in IndexedDB, mit zwei Buchhaltungsangaben, die wichtiger sind als die Orte selbst: der Radius, mit dem geholt wurde, und ob der Abruf tatsächlich fertig wurde.
Diese beiden Felder sind die ganze Regel für die Wiederverwendung. Ein Eintrag beantwortet deine Suche, wenn er vollständig ist und sein Radius mindestens so groß ist wie der, nach dem du fragst. Cafés bei den standardmäßigen 500 m anzuhaken ist also gar keine Suche: Es ist ein Nachschlagen, und die App misst die Abstände entlang deiner Route selbst. Zieh den Radius-Schieberegler über einen Kilometer, und der Cache-Eintrag deckt die Frage nicht mehr ab, also läuft die Korridorabfrage wieder ganz echt. Ein fehlgeschlagener Abruf wird als unvollständig vermerkt und nie wiederverwendet, denn „hier ist nichts“ und „wir haben es nie herausgefunden“ sind verschiedene Antworten.
Diesen Cache nach Route zu schlüsseln war, wie sich herausstellte, der falsche Instinkt: Ein Café bewegt sich nicht, wenn du einen Wegpunkt verschiebst, aber ein routenförmiger Schlüssel ändert sich dabei, und ein ganzer Korridor voller Orte ist verwaist. Die Einträge ziehen deshalb auf ein festes Raster geografischer Zellen um. Eine Zelle gehört zur Welt und nicht zu deiner Route, also beantwortet dieselbe Zelle die Route, die du bearbeitet hast, die Route, die du zweimal geladen hast, und die Route von jemand anderem auf derselben Straße.
Was der Geschichte oben etwas die Spitze nimmt. Den Großteil einer Sitzung ist die Datenbank gar nicht beteiligt: Du hakst Kategorien an, ziehst den Radius unter einen Kilometer, und nichts verlässt den Browser. Die Geschwindigkeit der Korridorabfrage steckt hinter einem Cache, und das ist der richtige Ort für sie, aber es heißt auch, dass die Zahlen in diesem Beitrag meistens nicht das sind, was du beim Planen spürst.
Die Abhängigkeit läuft allerdings andersherum. Alle Kategorien entlang einer 200-km-Route vorab zu laden, ist nur dank der Korridorabfrage bezahlbar: eine Anfrage pro Abschnitt, alle Kategorien darin, gefiltert in der Datenbank. Mit der Rechteck-Kette wäre dieselbe Gier Dutzende Anfragen pro Abschnitt gewesen, und das hätten wir nie gewagt. Der Cache ist das, was uns die schnelle Abfrage eingebracht hat.
Zählen, ohne zu holen
Manchmal willst du wissen, was vor dir liegt, bevor du irgendetwas davon holst: 84 Cafés, 2 Wasserhähne, gar keine Tankstelle. Die App kann dir das vorher sagen, und du entscheidest dann, wonach es sich lohnt zu fragen.
Das ist derselbe Korridor mit denselben Kandidaten, nur wird pro Kategorie nach einer Anzahl gefragt statt nach einer Liste von Orten. Es kommen überhaupt keine Punkte zurück, nur Zahlen, und genau darum geht es: Eine Obergrenze für die Anzahl zurückgegebener Zeilen kann eine Zählung nicht heimlich verfälschen, wenn gar keine Zeilen zurückkommen. Kategorien ohne Treffer entlang der Route liefern null, statt zu fehlen, denn „hier gibt es keine“ und „wir haben nicht nachgesehen“ sind verschiedene Antworten, und die Oberfläche sagt, welche sie hat.
Für SQL-Neugierige
Alles oben ist die Idee. Das hier ist die Abfrage, und vier Dinge, die man darüber wissen sollte.
CREATE OR REPLACE FUNCTION pois_along_route(
    route_geojson TEXT, radius_m INTEGER, filters JSONB
) RETURNS TABLE (...) LANGUAGE sql STABLE PARALLEL SAFE AS $
    WITH corridor AS (
        SELECT ST_Subdivide(
            ST_Buffer(
                ST_SetSRID(ST_GeomFromGeoJSON(route_geojson), 4326)::geography,
                radius_m
            )::geometry,
            64) AS cell
    ),
    candidates AS (
        SELECT DISTINCT p.osm_type, p.osm_id, p.geom, p.tags, p.osm_timestamp
        FROM pois p
        JOIN corridor c ON p.geom && c.cell AND ST_Intersects(p.geom, c.cell)
    )
    SELECT osm_type, osm_id, ST_Y(geom), ST_X(geom), tags, osm_timestamp
    FROM candidates
    WHERE poi_matches_filters(tags, filters);
$;
4326 ist ganz normales Lat/Lon. Jedes Koordinatensystem hat eine Nummer, und 4326 ist die, die die ganze Welt für Breiten- und Längengrade verwendet: Das liefert ein GPS, und das steht in einer GPX-Datei. ST_SetSRID sagt PostGIS, dass die eingehenden Zahlen genau das sind, denn GeoJSON trägt zwar die Koordinaten, aber nicht das System.
Puffern in Metern, vergleichen in Grad. Das Band muss in Metern gezeichnet werden, weil der Radius in Metern angegeben ist und der Import den ganzen Planeten umfasst: Ein gradbasierter Puffer, der für Oxfordshire passt, ist in Tromsø in Ost-West-Richtung kaum halb so breit, wie die beiden Bänder im Diagramm oben zeigen. Von Nord nach Süd ändert sich nichts, weil ein Breitengrad überall gleich lang ist, also kommt das Band gestaucht heraus statt schmaler. Der Vergleich aber muss Geometrie gegen Geometrie sein, sonst greift der Index nicht. Also zeichnest du das Band in geography, wandelst das Ergebnis zurück und vergleichst in geometry.
::geography ist ein Cast - SQL für die Umwandlung eines Werts von einem Typ in einen anderen -, und es ist derselbe wie in der einfachen Abfrage weiter oben, der die Aufgabe erfüllt, die das Tromsø-Diagramm zeigt.
Das Band zu zerschneiden ist der ganze Trick. Ein gepufferter 200-km-Korridor ist ein riesiges Polygon mit demselben nutzlosen Rechteck drumherum, also ist ein Test dagegen nicht besser als die naive Version. ST_Subdivide in Zellen mit höchstens 64 Eckpunkten ergibt Hunderte kleiner Polygone mit engen Rechtecken, und der Index ist für jedes davon wieder nützlich.
Zwei Tests pro Zelle, und nur einer davon ist teuer. p.geom && c.cell ist die Rechteck-Frage, die der Index beantwortet, und die wirft den Planeten weg; ST_Intersects ist der genaue Test, und der läuft nur auf dem, was den ersten überlebt hat. Dieses Paar ist der ganze Mechanismus, den dieser Beitrag beschrieben hat, ausgeschrieben.
Duplikate entfernen, denn die Abschnitte berühren sich. Ein Café, das genau auf der Naht zwischen zwei Abschnitten liegt, wird zweimal gefunden. Ein DISTINCT: billig zu beheben, albern, es ohne auszuliefern.
Die Zählabfrage ist dasselbe mit geänderter letzter Zeile: derselbe Korridor, dieselben Kandidaten, count(*) pro Kategorie statt der Zeilen selbst.
SELECT cat.key,
       count(*) FILTER (WHERE poi_matches_filters(cand.tags, cat.value))
FROM jsonb_each(categories) AS cat(key, value)
LEFT JOIN candidates cand ON true
GROUP BY cat.key;
Den Planer bitten, seinen Rechenweg zu zeigen
SQL sagt, was du willst, nie, wie man es bekommt, also muss irgendetwas über das Wie entscheiden: Das ist der Planer. Für eine Abfrage überlegt er sich die möglichen Wege, sie zu beantworten, schätzt, was jeder kosten würde, und nimmt den billigsten. Einen Index zu benutzen ist einer dieser Wege, und der Planer nimmt ihn nur, wenn er sieht, wie; sonst liest er die Tabelle von vorne bis hinten, und das heißt sequentieller Scan.
Die ::geography-Umwandlung macht das gleich doppelt kaputt. Die Spalte geom hat den Typ geometry, also kann der darauf angelegte Index nach der Umwandlung überhaupt nicht benutzt werden: Der Planer hat nichts, wo er nachschlagen könnte. Und selbst wenn er es könnte, wären wir wieder beim Rechteck, wo das Rechteck um eine 200 km lange Linie sowieso eine Million Kandidaten übergibt.
Du kannst den Planer mit EXPLAIN bitten, seinen Rechenweg zu zeigen, und hier ist er ziemlich unverblümt. Er gibt jedem Lösungsweg Kosten: eine Schätzung, wie viel Arbeit dieser Plan machen würde. Niedriger ist besser. Die Zahl ist intern und keine Sekunden, eine allein sagt dir also nichts, aber zwei nebeneinander sagen dir eine Menge.
Diese beiden Pläne stammen von der öffentlichen Postpass-Instanz, die dir auf Anfrage den Rechenweg ihres Planers zeigt, und zwar für die einfachere Version dieser Abfrage: einen Kreis um einen Punkt, bei dem dieselbe Umwandlung denselben Index auf dieselbe Weise aushebelt.
| Wie er antworten will | Geschätzte Kosten (niedriger ist besser) |
|---|---|
| Die Tabelle von vorne bis hinten lesen und jede Zeile messen | 4.500.000.000 |
| Erst die Rechtecke prüfen, dann die Überlebenden messen | 4.600 |
Dieselbe Frage, dieselben Daten, am Ende dieselbe Antwort. Der Planer erwartet, dass der eine Weg etwa eine Million Mal mehr Arbeit ist als der andere, und so sagt er dir, dass er deinen Index aufgegeben hat.
Vom Browser in die Datenbank
Bisher ging es um die Form der Abfrage, bis hinunter zum SQL. Dieses letzte Stück handelt davon, wer sie schreibt, und das ist, wie sich zeigt, der größere Unterschied zwischen dem, was wir betreiben, und dem Vorbild, nach dem es gebaut ist.
Der Browser schickt nie SQL.
server.js, danach gebundene Parameter für eine Funktion, die es schon gibt.Was den Browser verlässt, ist ein JSON-Objekt mit vier Feldern:
{
  "mode": "route",
  "route": [[[51.54, -0.90], [51.53, -0.92], ...]],
  "radius_m": 500,
  "filters": [[{"k": "amenity", "v": "cafe"}],
              [{"k": "amenity", "v": "drinking_water"}]]
}
route ist die ausgedünnte Linie aus „Bevor die Anfrage den Browser verlässt“. filters ist die Liste der Kategorien: eine oder mehrere Gruppen pro Kategorie, weil eine Kategorie auf mehrere Tag-Kombinationen passen kann. Da drin steht keine Abfrage, nur vier Werte.
nginx ist der Webserver, der vor unserem sitzt. Er terminiert TLS (das s in https) und erledigt die unspektakuläre Arbeit: Die Anfrage muss von einer pitstopper.net-Seite, unserer Handy-App oder einem lokalen Entwicklungs-Build kommen, drei Anfragen pro Sekunde mit Spitzen bis fünfzehn, 2 MB maximale Body-Größe. Ein Skript ganz ohne Origin-Header kommt trotzdem durch, und dafür gibt es das Ratenlimit. Dann hält er einen Antwort-Cache, dessen Schlüssel der Anfrage-Body ist, was nur geht, weil der Body eine feste Form hat. Zwei Leute, die nach denselben Kategorien entlang desselben Korridors fragen, teilen sich einen Weg zur Datenbank.
Dieser Cache darf eine Antwort 24 Stunden lang halten, was nach einem Widerspruch zu den stündlichen Updates klingt. Ist es nicht, denn jedes stündliche Update leert ihn als letzten Schritt. Die 24 Stunden sind eine Obergrenze, die nie erreicht wird: Eine wiederholte Suche ist höchstens ein Update hinterher, und der Neu-laden-Knopf pro Kategorie schickt ?nocache=1, um den Cache ganz zu umgehen.
server.js prüft die Form und die Grenzen, und das ist ehrlich gesagt alles, was es tut. Der Modus ist route oder point. Radius zwischen 25 m und 35 km. Höchstens 10.000 Punkte über höchstens 32 Routen; höchstens 128 Filtergruppen mit höchstens 8 Tag-Paaren; kein Tag länger als 256 Zeichen. Dann macht es aus [lat, lon] das [lon, lat] von GeoJSON und macht einen einzigen Aufruf:
pool.query('SELECT * FROM pois_along_route($1, $2, $3::jsonb)',
           [geojson, radius, filters]);
Das sind gebundene Parameter und keine aneinandergehängten Strings. Die Anweisung ist eine Konstante in der Datei, und die Werte reisen daneben mit, werden nie hineinkopiert, also gibt es nichts, was ein raffiniert benannter Tag einschmuggeln könnte: keine Möglichkeit, die Abfrage vorzeitig zu beenden und eine eigene neue anzufangen. Dieser Trick heißt SQL-Injection, und er leert schon seit den Neunzigern Datenbanken.
PostGIS erledigt dann alles, worum es im Rest dieses Beitrags geht. Die fünf Funktionen in schema.sql sind die gesamte Abfrageoberfläche: pois_along_route, pois_around_point, pois_count_by_category, ways_along_route und ways_around_point.
Weil die Zwischenschicht nichts enthält, könnte sie genauso gut PostgREST oder pg_featureserv sein, und weder der Client noch das SQL würden es merken. Das ist keine Ordnungsliebe um ihrer selbst willen. Genau das hat uns erlaubt, das ganze Backend auf der Staging-Seite gegen den alten Overpass-Weg laufen zu lassen, mit demselben Client und denselben Kategorien hinter einem Schalter, und Zahlen statt Meinungen zu bekommen.
Was nicht so ist, wie Postpass funktioniert, und zwar mit Absicht
Postpass nimmt SQL. Du schickst ihm per POST eine Anweisung, es führt sie aus, und du bekommst GeoJSON zurück. Das ist der Sinn der Sache, und genau deshalb war es das Richtige, um einen Prototyp dagegen zu bauen: Wir konnten eine Korridorabfrage gegen einen Spiegel des ganzen Planeten ausprobieren, ohne überhaupt etwas zu deployen.
Wir nutzen es immer noch, und nicht als Museumsstück. Die öffentliche Instanz von Geofabrik ist die Stufe, auf die wir zurückfallen, wenn beide unserer eigenen Knoten ausfallen, und seit das Overpass-Fan-out im August 2026 gelöscht wurde, steht nichts mehr dahinter: Postpass ist das Letzte, was zwischen dir und gar keiner Antwort steht.
Beide Formen aus diesem Bild sind also im selben Browser im Einsatz. Antwortet unser Server, hat der Client Parameter geschickt. Antwortet er nicht, baut derselbe Client ein SELECT und schickt es an Geofabrik. Eine Suche, zwei völlig verschiedene Vorstellungen davon, wer die Abfrage schreibt, zur Laufzeit danach ausgewählt, ob unsere Hardware läuft.
Den Tausch sollte man offen benennen.
Was wir aufgeben, ist Allgemeinheit. Jede Frage, an die wir nicht vorher gedacht haben, braucht eine neue Funktion und ein Deployment, wo jemand mit Postpass einfach ein anderes SELECT schreiben würde.
Was wir dafür bekommen, funktioniert nur, wenn die Form vorher feststeht. Der Planer sieht für immer dieselben fünf Anweisungen, also kann ein Plan einmal geprüft und dann vertraut werden, statt zur Anfragezeit aus irgendeinem eingetroffenen SQL ermittelt zu werden. Der Antwort-Cache kann den Body als Schlüssel nehmen. Und die Grenzen oben lassen sich durchsetzen, denn „höchstens 10.000 Punkte“ kann man über ein Feld sagen, aber nicht über eine Abfrage.
Was der Betrieb kostet
Gemessen am 12. September 2026 auf einem unserer beiden Knoten - srv01, der Anfragen als poi01 beantwortet -, mit einem Planet-Import und unserer Tag-Allowlist. Nicht geschätzt, und größer, als man es bei einem Beitrag über Points of Interest erwarten würde, aus einem Grund, der sich anzuschauen lohnt.
| POI-Zeilen | 75,7 Mio. |
| Way-Zeilen | 266 Mio. |
| Datenbank auf der Platte, inklusive Indizes | 219 GB |
| osm2pgsql-Flat-Nodes-Speicher | 106 GB |
| Gefiltertes Planet-PBF | 33 GB |
| Node-Server, belegter Speicher | 49 MB |
Die Datenbank teilt sich ungefähr so auf, jede Zahl inklusive der Indizes der jeweiligen Tabelle: ways sind 102 GB, die eigene planet_osm_ways-Zwischentabelle von osm2pgsql weitere 91 GB, und pois (die Tabelle, um die es in diesem ganzen Beitrag geht) nur 24 GB. Die POI-Hälfte ist die billige Hälfte. Teuer ist die volle Straßengeometrie, und die haben wir bewusst in Kauf genommen, für die drei Funktionen, die ein Mittelpunkt nicht bedienen kann.
Ein Way landet in beiden Tabellen. pois enthält seinen Mittelpunkt, der für ein Café in einem Gebäude genau richtig ist, und ways seine volle Geometrie, die als Einzige beantworten kann „Wo wechselt der Belag?“ oder „Setz diesen Punkt auf eine Straße“. Ein Mittelpunkt kann keinen Tunnel zeichnen.
Updates laufen stündlich; ein kompletter Neuaufbau aus dem Planet-File läuft monatlich. Die Herkunftszeile trägt beide Zeitstempel, denn „Wie alt ist das Fundament?“ und „Wie alt ist die neueste Änderung?“ sind verschiedene Fragen, und ein Wachhund für veraltete Daten braucht die erste.
Falls du Postpass betreibst
Damit klar ist, was wir übernommen haben und was nicht: Die Idee stammt von Postpass, der Code nicht. Wir betreiben kein Postpass, und unser Server ist kein Fork davon. Übernommen haben wir das Rezept, das jeder übernehmen kann - osm2pgsql in PostGIS, HTTP davor -, und dann ein paar hundert Zeilen geschrieben, um die fünf Fragen zu bedienen, die wir tatsächlich stellen. Wenn du das allgemeine Werkzeug brauchst, betreib Postpass. Es ist gut, und ein eigenes zu schreiben lohnt sich nur, wenn deine Anforderungen enger sind als die des Projekts, und das betrifft weniger Leute, als es klingt.
Egal, was du betreibst: Leg den Flat-Nodes-Speicher von osm2pgsql auf deine schnellste Platte. Es ist ein flaches Array, indexiert nach OSM-Node-ID, 106 GB davon, und so vermeidet der Import, die Node-Positionen des ganzen Planeten im RAM zu halten. Wir haben unseren einmal versehentlich auf eine USB-NVMe verschoben, und die stündlichen Updates gingen von 33 Sekunden auf 17 Minuten hoch.
Wenn du Routenkorridore auf deiner eigenen Instanz willst, nimm ST_Subdivide auf einem geography-Puffer und lass den Rest liegen. Dieser eine Aufruf ist der Unterschied zwischen einer Abfrage, die richtig aussieht, und einer, die läuft. Alles andere hier ist unser persönlicher Geschmack bei Tag-Filtern.
Noch etwas ist eine Stunde deiner Zeit wert, wenn du von Overpass umsteigst, statt neu anzufangen: Unser Antwortformat ist absichtlich Overpass-kompatibel, {elements: [...]} mit rohen Tags, Nodes mit lat/lon und Ways mit einem Mittelpunkt. Der Client, der mit Overpass gesprochen hat, brauchte einen Adapter und ungefähr einen Nachmittag.
Den Korridor selbst sehen
Alles, was oben abgebildet ist, findest du unter System → Suchbereich anzeigen in PitStopper, auf jeder geladenen Route. Es zeichnet metergenaue Kreise entlang der ausgedünnten Linie mit dem aktuellen Radius, sodass das Ziehen des Radius-Schiebereglers den echten Abfragebereich neu zeichnet. Wir haben es gebaut, um diese Arbeit zu debuggen, und es drin gelassen, denn eine räumliche Abfrage, die du nicht sehen kannst, ist eine räumliche Abfrage, bei der du rätst.